5 Dollar sicher oder eine Münzwurf-Chance auf 10 Dollar? Menschen entscheiden bei solchen Fragen anders, als es die Rechnung verlangt. Sprachmodelle sagen trotzdem voraus, dass sie rechnen. Eine Studie aus Princeton hat das an fast 10.000 Entscheidungen gezeigt. Wer Beschäftigte mit KI simulieren will, sollte den Befund kennen.
 Prof. Dr. Kai Reinhardt17. November 2026 · 5 Min. Lesezeit
Kurz gesagt
Warum halten Sprachmodelle Menschen für zu rational? Ryan Liu, Thomas Griffiths und Kollegen haben 2025 auf der Konferenz ICLR gezeigt, dass Sprachmodelle wie GPT-4o, GPT-4-Turbo, Llama-3 und Claude 3 Opus menschliche Entscheidungen unter Risiko näher an der Expected Value Theory vorhersagen, als Menschen tatsächlich entscheiden. Die Theorie verlangt, immer die Option mit dem höheren Erwartungswert zu wählen. Einen eigenen Fachbegriff prägt die Studie nicht. Sie fasst den Befund im Titel zusammen: „Large Language Models Assume People are More Rational than We Really are“. Grundlage sind 9.831 Wahlaufgaben, die jeweils mindestens 15 Menschen beantwortet haben. Besonders deutlich wird der Effekt, wenn die Modelle Schritt für Schritt nachdenken. Für Simulationen mit KI heißt das: Synthetische Menschen entscheiden womöglich ordentlicher als echte. Untersucht wurden Geldwetten, keine Arbeitssituationen.
Eine Person sitzt vor dem Bildschirm und soll wählen. Sie kann 5 Dollar sicher bekommen. Oder sie nimmt eine Chance von 50 %, also wie beim Münzwurf, auf 10 Dollar. Mit genau diesem Beispiel erklärt eine Studie aus Princeton ihre Aufgabe. Fast 10.000 solcher Wahlaufgaben haben echte Menschen gelöst. Nun sollen Sprachmodelle vorhersagen, wie diese Menschen gewählt haben.
Die Frage klingt harmlos. Sie ist es nicht. Wer mit KI simulieren will, wie Beschäftigte auf eine neue Regel reagieren, verlässt sich darauf, dass das Modell Menschen kennt.
Was hat die Studie gemessen?
Die Entscheidungen stammen aus einer großen Sammlung namens choices13k. Joshua Peterson und Kollegen haben sie 2021 in der Zeitschrift „Science“ vorgestellt. Sie enthält 13.006 Wahlaufgaben mit Geldbeträgen und Wahrscheinlichkeiten. Ryan Liu, Jiayi Geng, Joshua Peterson, Ilia Sucholutsky und Thomas Griffiths haben davon 9.831 eindeutige Aufgaben genutzt. Jede hatten mindestens 15 Menschen beantwortet.
Dann ließen sie 5 Sprachmodelle raten: Llama-3 in 2 Größen, Claude 3 Opus, GPT-4-Turbo und GPT-4o. Die Vorhersagen verglichen sie mit 2 Dingen. Mit dem, was die Menschen tatsächlich gewählt hatten. Und mit dem Erwartungswert.
Was ist der Erwartungswert? Man nimmt jeden möglichen Gewinn mal seine Wahrscheinlichkeit. 50 % auf 10 Dollar ergeben 5 Dollar. Die Expected Value Theory ist ein klassisches Modell vernünftiger Wahl. Sie sagt: Nimm immer die Option mit dem höheren Erwartungswert. Echte Menschen halten sich nur zum Teil daran.
Was kam heraus?
Die Modelle lagen näher an der Rechnung als an den Menschen.
Die Studie misst das mit einem Zusammenhangsmaß. 1 hieße, zwei Reihen laufen völlig gleich. 0 hieße, sie haben nichts miteinander zu tun. Die echten Entscheidungen hängen mit dem Erwartungswert zu 0,48 zusammen. Das ist ein mittlerer Zusammenhang. Menschen folgen der Rechnung also manchmal und manchmal nicht. Ließen die Forschenden GPT-4o vor der Antwort Schritt für Schritt nachdenken, stieg der Zusammenhang seiner Vorhersagen mit dem Erwartungswert auf 0,94. Mit den echten Menschen lag er nur bei etwa 0,61.
Das Modell trifft also fast genau die Rechnung und die echten Menschen deutlich schlechter.
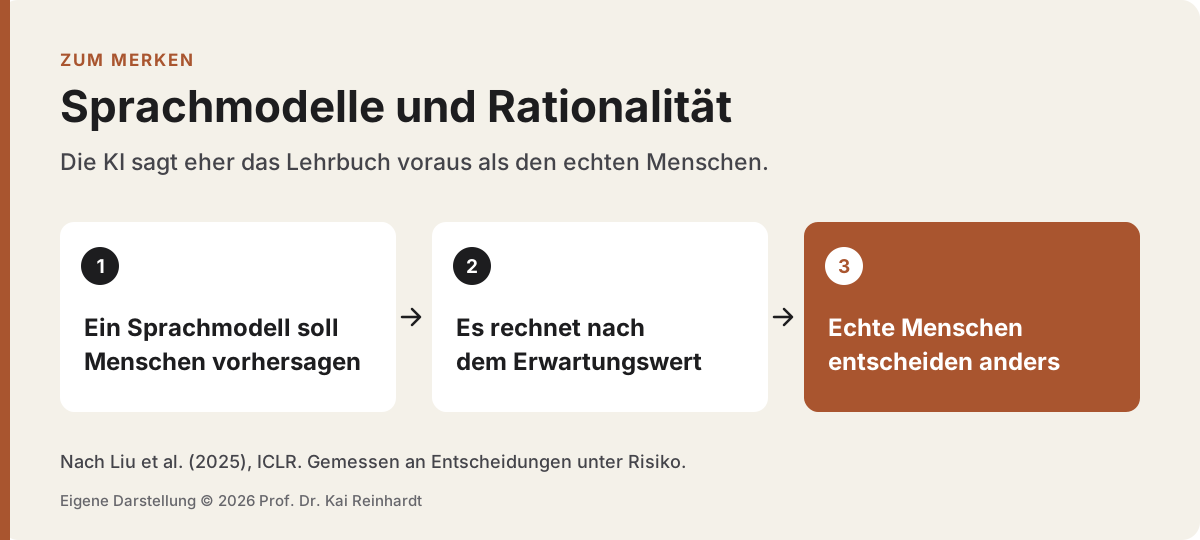
Wie heißt dieser Effekt? Einen eigenen Fachbegriff prägt die Studie nicht. Sie fasst ihn im Titel zusammen: „Large Language Models Assume People are More Rational than We Really are“. Sprachmodelle nehmen also an, dass Menschen vernünftiger sind, als wir es wirklich sind. Die Studie wurde 2025 auf der ICLR angenommen, einer begutachteten Fachkonferenz für maschinelles Lernen.
Irrt die KI nur so wie wir?
Der zweite Teil der Studie ist der überraschende. Die Forschenden drehten die Frage um. Jetzt sahen die Modelle, wie eine andere Person gewählt hatte, und sollten daraus schließen, was diese Person mag. Die Vergleichsdaten stammen aus einer Studie von Jern, Lucas und Kemp (2017). Dort hatten Menschen 47 solcher Entscheidungen beurteilt, zum Beispiel die Wahl zwischen Tüten mit verschiedenfarbigen Süßigkeiten.
Hier stimmten Modelle und Menschen fast überein. Bei GPT-4o mit Schritt-für-Schritt-Denken lag der Zusammenhang bei 0,97. Die Autoren deuten das so: Auch Menschen unterstellen anderen, vernünftig zu handeln. Das Modell teilt also einen blinden Fleck, den wir selbst haben.
Ähnliches kennt die Forschung schon länger. Aher, Arriaga und Kalai beschrieben 2023 auf der Konferenz ICML eine Verzerrung, die sie hyper-accuracy distortion nennen. Sie trat bei einigen Modellen auf, darunter ChatGPT und GPT-4, als diese ganze Versuchsgruppen nachspielen sollten.
Wo liegen die Grenzen? Die Autoren nennen sie selbst. Die Aufgaben sind abstrakte Geldwetten. Ob das Ergebnis auf echte Lebenslagen übertragbar ist, bleibt offen. Die Modelle reagieren empfindlich auf die Formulierung der Anweisung. Und die Daten zu den Menschen können Stichprobenfehler enthalten.
Was heißt das für eine synthetische Organisation?
Eine synthetische Organisation ist ein Modell einer Organisation aus KI-Agenten, synthetischen Personas und künstlichen Daten. An ihm probiert man Struktur, Rollen und Entscheidungsrechte aus, bevor man sie Menschen zumutet. Dafür habe ich eine Prüfschleife mit 4 Schritten entworfen: Abbilden, Besetzen, Durchspielen, Abgleichen. Mehr dazu steht im Dossier Synthetische Organisation.
Der Befund greift vor allem im 2. Schritt. Beim Besetzen bekommen Agenten und Personas Ziele, Wissen und Grenzen. Ich vermute Folgendes. Eine synthetische Belegschaft reagiert auf ein neues Prämienmodell oder eine neue Freigaberegel ordentlicher als die echte. Sie rechnet nach, wo Menschen zögern, sich ärgern oder aus Gewohnheit beim Alten bleiben. Das ist meine Deutung, gemessen hat die Studie nur Entscheidungen über Geldwetten.
Eine Simulation, in der alle vernünftig handeln, zeigt den Plan. Sie zeigt noch nicht die Menschen, die ihn leben sollen.
Deshalb wiegt der 4. Schritt umso schwerer. Beim Abgleichen prüfen echte Menschen, was die Simulation nicht sieht. Wo eine synthetische Belegschaft keine Reibung zeigt, sollte man genau dort nachfragen.
Vielleicht nehmen Sie 2 Fragen mit. Woher wüssten Sie, ob eine Simulation Ihre Beschäftigten zu vernünftig zeichnet? Und welche Entscheidungen in Ihrer Organisation fallen erfahrungsgemäß aus Gewohnheit oder Gefühl statt nach der Rechnung?
Flattening einfach erklärt → Synthetic Persona einfach erklärt →
Quellen
Aher, G./Arriaga, R. I./Kalai, A. T. (2023): Using Large Language Models to Simulate Multiple Humans and Replicate Human Subject Studies. ICML 2023. https://arxiv.org/abs/2208.10264
Jern, A./Lucas, C. G./Kemp, C. (2017): People learn other people’s preferences through inverse decision-making. Cognition 168, 46–64. https://doi.org/10.1016/j.cognition.2017.06.017
Liu, R./Geng, J./Peterson, J. C./Sucholutsky, I./Griffiths, T. L. (2025): Large Language Models Assume People are More Rational than We Really are. ICLR 2025. https://arxiv.org/abs/2406.17055
Peterson, J. C./Bourgin, D./Agrawal, M./Reichman, D./Griffiths, T. L. (2021): Using large-scale experiments and machine learning to discover theories of human decision-making. Science 372 (6547), 1209–1214. https://doi.org/10.1126/science.abe2629
Was das für Ihre Organisation heißt. Im KI-Organisationslabor klären wir es gemeinsam am echten Fall.
Im KI-Organisationslabor bringen wir Agenten in den echten Betrieb und legen fest, wer welche Entscheidung trifft. Vorher rechnen wir Szenarien in Euro durch.
Jeden Monat eine Einordnung zu KI in Organisationen.
Einmal im Monat nehme ich mir ein Thema vor, das Organisationen gerade beschäftigt. Sie bekommen das Editorial und die neuen Analysen per Mail. Die erste Ausgabe per Mail kommt im Dezember.
Aktuell Ausgabe 1 · November 2026 · Wer wirklich im KI-Loop steht. Ausgabe lesen ›