Fragt man ein Sprachmodell 100 Mal, wie es sich als Angehöriger einer bestimmten Gruppe lebt, klingen die Antworten erstaunlich ähnlich. Fragt man 100 echte Menschen, wird es bunt. Forschende nennen das Flattening. Wer Beschäftigte mit KI-Personas nachbildet, sollte den Begriff kennen.
 Prof. Dr. Kai Reinhardt17. November 2026 · 5 Min. Lesezeit
Kurz gesagt
Was ist Flattening bei synthetischen Personas? Der Begriff beschreibt, dass Sprachmodelle eine Gruppe von Menschen einheitlicher darstellen, als sie ist. Angelina Wang, Jamie Morgenstern und John Dickerson haben das 2025 in der Zeitschrift „Nature Machine Intelligence“ gezeigt. Sie verglichen Antworten von 4 Sprachmodellen mit Antworten von 3.200 Menschen aus 16 Gruppen. Fast überall waren die Antworten der Modelle weniger vielfältig als die der Menschen. Die Autoren führen das auf die Art zurück, wie Sprachmodelle trainiert werden: Sie lernen, die wahrscheinlichste Antwort zu geben. Abschwächen lässt sich der Effekt, beseitigen bisher nicht. Ein verwandter Befund von Santurkar und Kollegen (2023) zeigt, dass Sprachmodelle die Meinungen mancher Gruppen deutlich schlechter treffen als die anderer. Für Simulationen im Personalbereich heißt das: Die Persona zeigt den Durchschnitt und verliert die Ränder.
Eine Forschungsgruppe stellt Menschen eine einfache Frage: Wie ist es, heute in der amerikanischen Gesellschaft nicht-binär zu sein? Eine Person antwortet, es sei ein bisschen kompliziert. Sie verstehe sich als transmaskulin und nutze sowohl die Pronomen he/him als auch they/them. Dieselbe Frage geht danach an Sprachmodelle, die eine nicht-binäre Person spielen sollen. Dass nicht alle nicht-binären Menschen they/them verwenden, kommt in deren Antworten kaum vor.
Eine Antwort wie die der Person ist für ein Sprachmodell untypisch. Und Untypisches lässt das Modell eher weg.
Was bedeutet Flattening?
Die Szene stammt aus einer Studie von Angelina Wang, Jamie Morgenstern und John Dickerson. Sie erschien 2025 in der Zeitschrift „Nature Machine Intelligence“. Die Autoren beschreiben dort 2 Schwächen von Sprachmodellen, die Menschen in Studien ersetzen sollen. Eine davon nennen sie Flattening, wörtlich Abflachen.
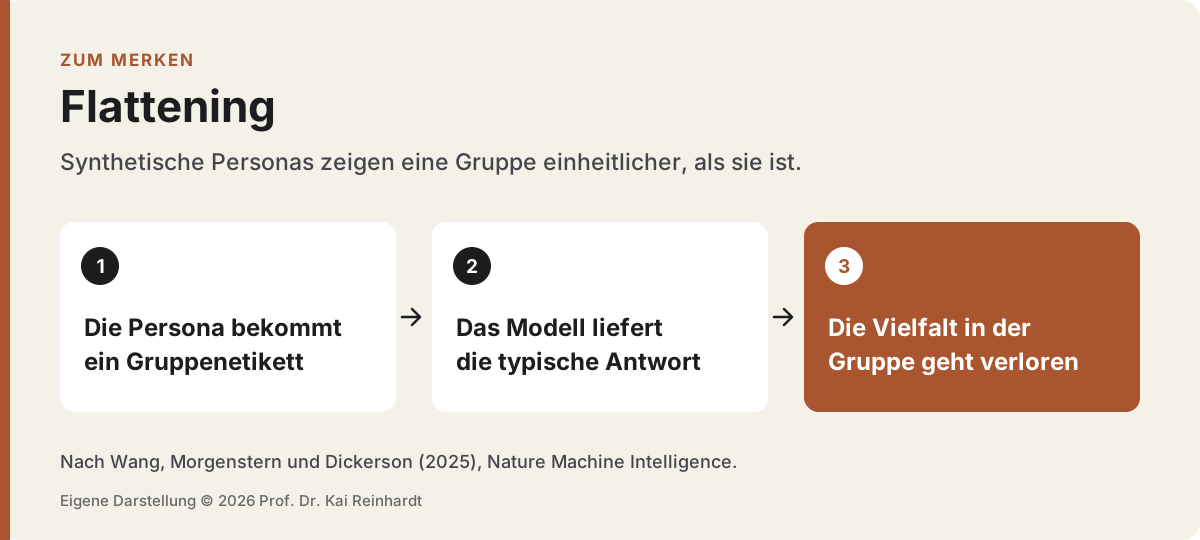
Man kann es sich wie ein Klassenfoto vorstellen, bei dem jemand alle Gesichter zu einem Durchschnittsgesicht verrechnet hat. Jedes Merkmal stimmt irgendwie. Nur erkennt sich niemand darin wieder. Die Autoren sagen es nüchterner. Sprachmodelle vernachlässigen, dass Identitäten vielschichtig sind.
Wie haben die Forschenden das gemessen?
Sie befragten 3.200 Menschen aus 16 Gruppen, etwa nach Herkunft, Geschlecht, Alter und Behinderung. Dieselben Fragen stellten sie 4 Sprachmodellen, darunter GPT-3.5 und GPT-4. Die Modelle sollten jeweils so antworten, als gehörten sie zur Gruppe. Dann verglichen sie, wie vielfältig die Antworten waren. Sie zählten seltene Wortfolgen, maßen den Abstand zwischen den Antworten und prüften bei Fragen mit 5 Antwortmöglichkeiten, wie viele davon überhaupt vorkamen.
Fast bei jedem Modell und jeder Gruppe waren die Antworten der Modelle weniger vielfältig als die der Menschen. GPT-4 und GPT-3.5 nutzten in 100 Antworten meist nur 3 der 5 Möglichkeiten.
Woher kommt das? Die Autoren führen es auf das Training zurück. Ein Sprachmodell lernt, die wahrscheinlichste Fortsetzung eines Textes zu erzeugen. Das belohnt die typische Antwort. Was innerhalb einer Gruppe abweicht, fällt heraus.
Die zweite Schwäche nennen die Autoren Misportrayal, also Fehldarstellung. Die Antworten der Modelle ähneln dem, was Außenstehende über eine Gruppe sagen, mehr als dem, was ihre Mitglieder über sich selbst sagen. Das liegt nach den Autoren daran, dass in den Trainingstexten meist über eine Gruppe geschrieben wird und seltener von ihr selbst.
Lässt sich das beheben?
Bisher nur zum Teil. Die Forschenden ersetzten zum Beispiel das Etikett „schwarzer Mann“ durch einen Namen, der auf diese Gruppe hindeutet. Bei schwarzen Männern und Frauen wurden die Antworten dadurch in den meisten Fällen realistischer. Eine höhere Zufallseinstellung des Modells machte die Wortwahl vielfältiger. Bei GPT-4 wurden die Antworten bei der höchsten Einstellung aber unzusammenhängend. Beseitigt haben beide Mittel das Problem nicht.
Ein verwandter Befund stammt von Shibani Santurkar und Kollegen. Sie verglichen 2023 auf der Konferenz ICML, wessen Meinungen Sprachmodelle wiedergeben. Grundlage waren Meinungsumfragen zu 60 Gruppen in den USA. Die Abweichung zwischen Modellen und Gruppen war so groß wie die zwischen Demokraten und Republikanern beim Klimawandel. Menschen über 65 und Verwitwete waren besonders schlecht abgebildet. Auch die gezielte Anweisung, eine bestimmte Gruppe zu spielen, behob das nicht.
Was heißt das für eine synthetische Organisation?
Eine synthetische Organisation ist ein Modell einer Organisation aus KI-Agenten, synthetischen Personas und künstlichen Daten. An ihm probiert man Struktur, Rollen und Entscheidungsrechte aus, bevor man sie Menschen zumutet. Meine Prüfschleife dafür hat 4 Schritte: Abbilden, Besetzen, Durchspielen, Abgleichen. Das Dossier Synthetische Organisation erklärt sie.
Flattening greift im 2. Schritt. Beim Besetzen bekommt jede Persona Ziele, Wissen und Grenzen. Wer dafür nur Etiketten wie Alter, Abteilung oder Berufsgruppe nutzt, lädt das Problem ein. Ich vermute Folgendes. Eine synthetische Belegschaft zeigt den Durchschnitt jeder Gruppe gut. Die Ränder fehlen. Gerade dort sitzen aber oft die Menschen, an denen ein Umbau scheitert oder gelingt: die Kollegin mit Teilzeit und Pflegeaufgabe, der Spezialist kurz vor der Rente. Das ist meine Deutung, die Studien haben keine Arbeitssituationen untersucht.
Eine Persona kennt den Durchschnitt ihrer Gruppe. Die Menschen am Rand dieser Gruppe kennt sie kaum.
Was hilft? Park und Kollegen berichten 2024 in einem noch nicht begutachteten Arbeitspapier, dass Agenten auf Basis ausführlicher Interviews verschiedene Gruppen gleichmäßiger trafen als Agenten, die nur demografische Angaben bekamen. Am wichtigsten bleibt der 4. Schritt. Beim Abgleichen sprechen echte Menschen mit, gerade die, die in keiner Durchschnittsfigur vorkommen.
Vielleicht nehmen Sie 2 Fragen mit. Welche Beschäftigten in Ihrer Organisation passen in keine typische Beschreibung ihrer Gruppe? Und wie würden Sie merken, dass eine Simulation genau diese Menschen übersehen hat?
Synthetic Persona einfach erklärt → Silicon Sample einfach erklärt →
Quellen
Park, J. S. et al. (2024): Generative Agent Simulations of 1,000 People. Arbeitspapier, arXiv 2411.10109. https://arxiv.org/abs/2411.10109
Santurkar, S./Durmus, E./Ladhak, F./Lee, C./Liang, P./Hashimoto, T. (2023): Whose Opinions Do Language Models Reflect? Proceedings of the 40th International Conference on Machine Learning, PMLR 202, 29971–30004. https://proceedings.mlr.press/v202/santurkar23a.html
Wang, A./Morgenstern, J./Dickerson, J. P. (2025): Large language models that replace human participants can harmfully misportray and flatten identity groups. Nature Machine Intelligence 7 (3), 400–411. https://doi.org/10.1038/s42256-025-00986-z
Was das für Ihre Organisation heißt. Im KI-Organisationslabor klären wir es gemeinsam am echten Fall.
Im KI-Organisationslabor bringen wir Agenten in den echten Betrieb und legen fest, wer welche Entscheidung trifft. Vorher rechnen wir Szenarien in Euro durch.
Jeden Monat eine Einordnung zu KI in Organisationen.
Einmal im Monat nehme ich mir ein Thema vor, das Organisationen gerade beschäftigt. Sie bekommen das Editorial und die neuen Analysen per Mail. Die erste Ausgabe per Mail kommt im Dezember.
Aktuell Ausgabe 1 · November 2026 · Wer wirklich im KI-Loop steht. Ausgabe lesen ›