Ein Baumarkt erhöht nach einem Schneesturm den Preis für Schneeschaufeln. Ist das fair? 1986 fragten Forschende Menschen, heute fragen Ökonomen auch Sprachmodelle. Den Ansatz nennen John Horton und Kollegen Homo silicus. Die Idee ist anregend. Wer sie nutzt, sollte auch wissen, wer an ihr verdient.
 Prof. Dr. Kai Reinhardt17. November 2026 · 5 Min. Lesezeit
Kurz gesagt
Was ist Homo silicus? Der Begriff stammt von John Horton, Apostolos Filippas und Benjamin Manning, zuerst 2023 als Arbeitspapier. Sie schlagen vor, große Sprachmodelle als rechnendes Modell des Menschen zu nutzen. So wie Ökonomen mit dem Homo oeconomicus arbeiten, gibt man dem Modell eine Rolle, eine Ausgangslage und Vorlieben und lässt es Entscheidungen treffen. In 5 Experimenten zeigten die Modelle Ergebnisse, die den Befunden mit Menschen in der Richtung ähneln. Die Autoren betonen, dass die Ergebnisse an echten Menschen bestätigt werden müssen. Das Papier ist nicht begutachtet. Die Autoren legen offen, dass Horton Anthropic als Ökonom berät und alle 3 ein finanzielles Interesse an der Firma Expected Parrot haben, deren Software solche Simulationen anbietet.
Ein Baumarkt hat Schneeschaufeln bisher für 15 Dollar verkauft. Am Morgen nach einem heftigen Schneesturm verlangt er 20 Dollar. Ist das fair? Diese Frage stellten Daniel Kahneman, Jack Knetsch und Richard Thaler 1986 Menschen in Toronto und Vancouver am Telefon. Etwa 82 % fanden die Preiserhöhung unfair oder sehr unfair. Fast 40 Jahre später stellen Forschende dieselbe Frage einem Sprachmodell, und zwar in 24 Varianten.
Was ist Homo silicus?
Das Experiment mit dem Sprachmodell stammt von John Horton, Apostolos Filippas und Benjamin Manning. Sie nennen ihren Ansatz Homo silicus. Der Name spielt auf den Homo oeconomicus an. So heißt in der Ökonomie das Modell eines Menschen, der stets rational seinen Nutzen abwägt. Niemand hält ihn für einen echten Menschen. Er ist ein Werkzeug, mit dem man im Kopf durchspielt, was passieren müsste.
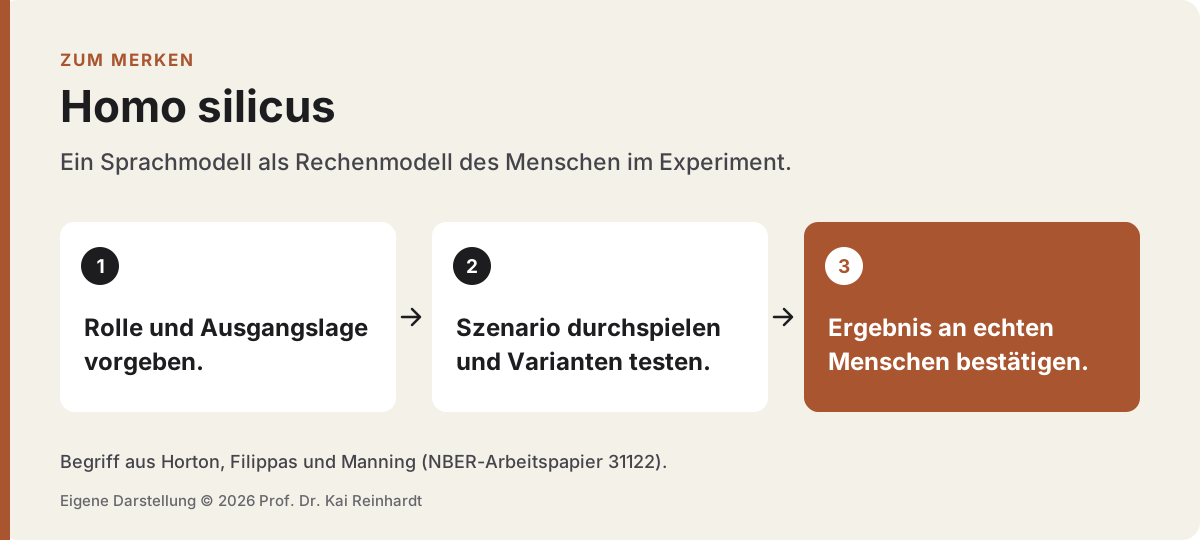
Horton und Kollegen schlagen vor, Sprachmodelle genauso zu nutzen. Man gibt dem Modell eine Rolle, Wissen und Vorlieben und schaut, wie es in einem Szenario entscheidet. Der Unterschied liegt im Verfahren. Beim Homo silicus wird simuliert statt gerechnet. Die Autoren sagen selbst, dass jeder Homo silicus falsch ist, wie jedes Modell. Ob er nützlich ist, sei eine andere Frage.
Was zeigen die Experimente?
Zurück zu den Schneeschaufeln. Die Forschenden gaben GPT-4 politische Haltungen vor, von „Sie sind Sozialist“ bis „Sie sind Libertärer“. Dann fragten sie nach Preiserhöhungen auf 16, 20, 40 und 100 Dollar, je 100 Mal. Linke Rollen fanden schon die ursprüngliche Erhöhung unfair. Konservative und libertäre Rollen sahen Preiserhöhungen gelassener. Und je höher der Preis, desto unfairer fanden sie ihn. Selbst einige konservative Rollen lehnten die 100 Dollar ab.
Was heißt das? Das Modell reagiert auf die Rolle so, wie man es von Menschen erwarten würde. Und man kann in Minuten Varianten testen, die 1986 niemand abgefragt hat.
Die Autoren haben 4 weitere Experimente nachgestellt. In einem soll ein Arbeitgeber eine Spülkraft einstellen. Führt man einen Mindestlohn ein, wählt das Modell im Schnitt erfahrenere und teurere Bewerber. Das passt in der Richtung zu einem Feldexperiment mit echten Arbeitgebern. In einem anderen geht es um die Neigung, am Bestehenden festzuhalten. Hier unterschieden sich die Modelle stark. Manche Modelle bevorzugten stark, was als bisheriger Zustand vorgegeben war, andere kaum.
Wichtig ist ein Wort, das die Autoren mit Absicht wählen. Sie schreiben bewusst „recapitulate“, also nachzeichnen. Das Wort „replicate“ für eine echte Wiederholung meiden sie. Die Ergebnisse seien in der Richtung ähnlich. Abweichungen könnten neue Forschungsfragen anstoßen.
Wer hat ein Interesse daran?
Das Papier erschien zuerst 2023 als Arbeitspapier, unter anderem beim National Bureau of Economic Research. Die aktuelle Fassung ist von Februar 2026. Begutachtet ist es nicht.
Auf der ersten Seite steht eine Offenlegung. Horton berät das KI-Unternehmen Anthropic als Ökonom. Alle 3 Autoren haben ein finanzielles Interesse an Expected Parrot. Diese Firma stellt die Software bereit, mit der sich die Experimente des Papiers wiederholen lassen. Das macht die Befunde nicht falsch. Die Offenheit spricht für die Autoren. Wer aber liest, dass Simulationen billig und schnell sind, sollte wissen, dass hier auch Anbieter schreiben.
Die Autoren bremsen selbst. Am Ende zählt nach ihren Worten das Verhalten echter Menschen. Ergebnisse aus KI-Experimenten brauchen eine Bestätigung an ihnen. Sie sehen die Simulation als günstigen Vorlauf. Andere Forschende haben inzwischen gezeigt, dass Sprachmodelle Menschen für rationaler halten, als sie sind. Das beschreibt der Beitrag Warum Sprachmodelle Menschen für zu rational halten.
Was bedeutet das für eine synthetische Organisation?
In einer synthetischen Organisation probiert man Rollen und Entscheidungsrechte an einem Modell aus, bevor man sie Menschen zumutet. Dafür habe ich eine eigene Prüfschleife aus 4 Schritten entworfen. Homo silicus gehört in den 3. Schritt, das Durchspielen. Man lässt Fälle laufen und ändert eine Bedingung nach der anderen.
Ich vermute Folgendes. Für eine Organisation liegt der Wert genau dort, wo ihn Horton und Kollegen auch sehen. Man kann viele Varianten günstig vorab erkunden, etwa eine neue Freigaberegel in 10 Fassungen. Was dabei auffällt, ist eine Frage an die Wirklichkeit und noch keine Antwort. Das ist meine Übertragung, die Autoren haben keine Organisationen untersucht.
Ein Homo silicus liefert gute Fragen an die Wirklichkeit. Die Antworten geben weiterhin Menschen.
Deshalb folgt auf das Durchspielen immer der 4. Schritt, das Abgleichen mit echten Menschen. Wie man künstliche Befragte für ganze Gruppen zusammensetzt, steht im Beitrag zum Silicon Sample.
Warum Sprachmodelle Menschen für zu rational halten → Silicon Sample →
Fragen für die eigene Organisation.
Vielleicht nehmen Sie 3 Fragen mit. Welche Regel in Ihrem Haus würden Sie gern in 10 Varianten durchspielen, bevor sie gilt? Wer bei Ihnen würde prüfen, ob die Simulation mit dem Verhalten echter Kolleginnen und Kollegen übereinstimmt? Und wissen Sie bei den Werkzeugen, die Ihnen angeboten werden, wer an ihnen verdient?
Quellen
Horton, J. J., Filippas, A., & Manning, B. S. (2023, überarbeitet 2026): Large Language Models as Simulated Economic Agents: What Can We Learn from Homo Silicus? NBER Working Paper 31122. https://www.nber.org/papers/w31122 Aktuelle Fassung: https://arxiv.org/abs/2301.07543
Kahneman, D., Knetsch, J. L., & Thaler, R. (1986): Fairness as a Constraint on Profit Seeking: Entitlements in the Market. American Economic Review 76(4), 728–741. https://ideas.repec.org/a/aea/aecrev/v76y1986i4p728-41.html
Liu, R., Geng, J., Peterson, J. C., Sucholutsky, I., & Griffiths, T. L. (2025): Large Language Models Assume People are More Rational than We Really are. ICLR 2025. https://arxiv.org/abs/2406.17055
Was das für Ihre Organisation heißt. Im KI-Organisationslabor klären wir es gemeinsam am echten Fall.
Im KI-Organisationslabor bringen wir Agenten in den echten Betrieb und legen fest, wer welche Entscheidung trifft. Vorher rechnen wir Szenarien in Euro durch.
Jeden Monat eine Einordnung zu KI in Organisationen.
Einmal im Monat nehme ich mir ein Thema vor, das Organisationen gerade beschäftigt. Sie bekommen das Editorial und die neuen Analysen per Mail. Die erste Ausgabe per Mail kommt im Dezember.
Aktuell Ausgabe 1 · November 2026 · Wer wirklich im KI-Loop steht. Ausgabe lesen ›