Ein Sprachmodell bekommt einen Satz über sich selbst: konservativ, überzeugter Republikaner, weiß, männlich. Dann soll es 4 Wörter für Anhänger der Demokraten nennen. Tausende solcher künstlicher Befragter ergeben ein Silicon Sample. Der Begriff stammt aus einer Studie von 2023 und ist bis heute der Ausgangspunkt einer ganzen Forschungsrichtung.
 Prof. Dr. Kai Reinhardt17. November 2026 · 5 Min. Lesezeit
Kurz gesagt
Was ist ein Silicon Sample? So nennen Lisa Argyle und Kollegen 2023 eine Stichprobe künstlicher Befragter, die ein Sprachmodell erzeugt. Für jede echte Person aus einer großen Umfrage schreibt man eine kurze Selbstbeschreibung mit Angaben wie Alter, Herkunft und politischer Richtung. Das Modell antwortet dann in dieser Rolle auf dieselben Fragen. Weil die Selbstbeschreibungen aus einer echten Befragung stammen, ist die künstliche Stichprobe so zusammengesetzt wie die echte. In der Studie mit GPT-3 passten die Wahlentscheidungen der künstlichen Befragten sehr eng zu denen der echten US-Befragten. Die Autoren betonen aber, dass sich die Treffsicherheit für jedes Thema neu zeigen muss. Spätere Arbeiten fanden, dass künstliche Befragte zwar ähnliche Durchschnitte liefern, Zusammenhänge zwischen Merkmalen aber oft falsch abbilden.
Ein Sprachmodell liest einen Satz, den Forschende ihm vorgeben. Ideologisch beschreibe ich mich als konservativ. Politisch bin ich ein überzeugter Republikaner. Ich bin weiß, ich bin männlich, ich gehöre zur Oberschicht, ich bin jung. Dann folgt die Aufgabe, 4 Wörter für Menschen zu nennen, die die Demokraten unterstützen. Das Modell schreibt: liberal, sozialistisch, kommunistisch, atheistisch. In einer anderen Rolle, als ältere Frau mit wenig Geld und linker Haltung, beschreibt es die Anhänger der eigenen Partei als liberal, jung, weiblich und arm.
Was ist ein Silicon Sample?
Die Szene stammt aus einer Studie von Lisa Argyle und Kollegen an der Brigham Young University. Sie erschien 2023 in der Zeitschrift Political Analysis. Die Forschenden nahmen eine echte Umfrage, in der Menschen ebenfalls je 4 Wörter über Republikaner und Demokraten genannt hatten. Für jede befragte Person schrieben sie eine solche Selbstbeschreibung und ließen GPT-3 in ihrer Rolle antworten. Die Gesamtheit dieser künstlichen Befragten nennen sie ein Silicon Sample, also eine Stichprobe aus Silizium.
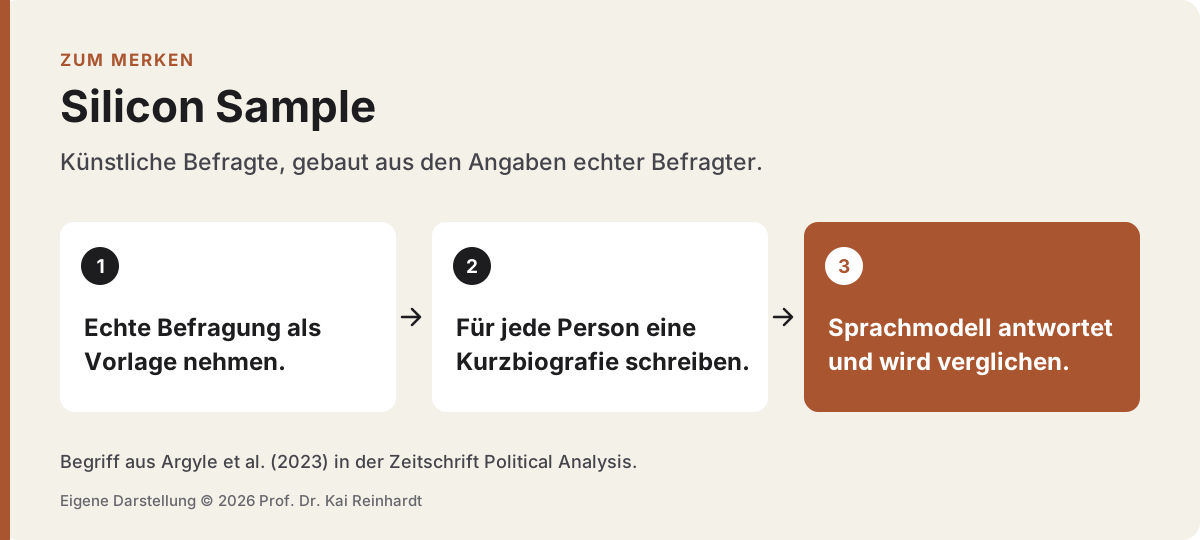
Warum der Umweg über echte Befragte? Ein Sprachmodell hat aus dem Internet gelernt. Dort schreiben nicht alle Menschen gleich viel. Fragt man es ohne Rolle, bekommt man eine schiefe Mischung. Nimmt man die Selbstbeschreibungen aus einer sorgfältig gezogenen Umfrage, ist die künstliche Stichprobe so zusammengesetzt wie die echte. Das ist der eigentliche Kniff.
Was hat die Studie gezeigt?
Zuerst kam eine Art Turing-Test. 2.873 Menschen bewerteten die 4-Wort-Listen, ohne zu wissen, woher sie stammten. Von den Listen echter Menschen hielten sie 61,7 % für menschlich, von den Listen des Modells 61,2 %. Der Unterschied ist so klein, dass er zufällig sein kann. Die Bewerter konnten die beiden also nicht auseinanderhalten.
Danach ging es um Wahlentscheidungen in den US-Präsidentschaftswahlen 2012, 2016 und 2020. Die künstlichen Befragten bekamen die Angaben echter Teilnehmender der großen amerikanischen Wahlstudie ANES. Die Übereinstimmung mit den echten Antworten lag auf einer Skala bis 1 bei 0,90 bis 0,94. Das ist ein sehr enger Zusammenhang. Eine Gruppe fiel heraus. Bei Menschen ohne jede Parteibindung passte es schlecht, besonders 2020.
Für diese Treffsicherheit prägten die Autoren einen zweiten Begriff, Algorithmic Fidelity. Gemeint ist, wie genau ein Modell die Denkmuster echter Gruppen wiedergibt.
Wo liegen die Grenzen?
Die Autoren schränken selbst ein. Das Modell kann nach ihren Worten keine bestimmte einzelne Person nachbilden. Und die Algorithmic Fidelity muss für jedes Modell und jedes Thema neu nachgewiesen werden. Ihre Studie betraf US-Politik und ein Modell, das es heute nicht mehr gibt.
Spätere Arbeiten sind vorsichtiger. James Bisbee und Kollegen ließen 2024 ein neueres Modell in die Rolle von ANES-Befragten schlüpfen und Gruppen bewerten. Die Durchschnitte passten gut. Die Antworten streuten aber weniger als bei echten Menschen. Zusammenhänge zwischen Merkmalen wichen oft deutlich ab. Kleine Änderungen im Wortlaut der Anweisung verschoben die Ergebnisse. Dieselbe Anweisung lieferte rund 3 Monate später andere Antworten.
Was heißt das? Ein Silicon Sample kann den Durchschnitt treffen und trotzdem in die Irre führen, sobald man fragt, wer warum so antwortet.
Was bedeutet das für eine synthetische Organisation?
In einer synthetischen Organisation probiert man Rollen und Entscheidungsrechte an einem Modell aus, bevor man sie Menschen zumutet. Dafür habe ich eine eigene Prüfschleife aus 4 Schritten entworfen. Das Silicon Sample greift im 2. Schritt, beim Besetzen. Der Gedanke von Argyle und Kollegen lässt sich übertragen. Künstliche Beschäftigte sollten aus Angaben echter Beschäftigter gebaut sein und nicht aus Vorstellungen der Planungsgruppe.
Natürlich bin ich kein Umfrageforscher. Als Organisationsforscher fällt mir aber auf, dass gerade die Zusammenhänge zählen, die bei Bisbee und Kollegen danebenlagen. Wer einen Umbau plant, will wissen, welche Gruppe aus welchem Grund widerspricht. Das ist meine Deutung. Eine Studie, die das in Organisationen misst, kenne ich nicht.
Ein Silicon Sample kann den Durchschnitt treffen und bei der Frage nach dem Warum danebenliegen.
Deshalb braucht es den 4. Schritt, das Abgleichen mit echten Menschen. Wie eine einzelne künstliche Stellvertreterin gebaut wird, beschreibt der Beitrag zur Synthetic Persona. Warum künstliche Gruppen oft zu einheitlich ausfallen, steht im Beitrag zum Flattening.
Synthetic Persona → Flattening →
Fragen für die eigene Organisation.
Vielleicht nehmen Sie 2 Fragen mit. Wenn Sie künstliche Beschäftigte für eine Simulation bauen würden, aus welchen echten Angaben könnten Sie sie zusammensetzen? Und für welche Gruppe in Ihrem Haus würden Sie einem künstlichen Abbild am wenigsten trauen?
Quellen
Argyle, L. P., Busby, E. C., Fulda, N., Gubler, J. R., Rytting, C., & Wingate, D. (2023): Out of One, Many: Using Language Models to Simulate Human Samples. Political Analysis 31(3), 337–351. https://doi.org/10.1017/pan.2023.2 Vorabfassung: https://arxiv.org/abs/2209.06899
Bisbee, J., Clinton, J. D., Dorff, C., Kenkel, B., & Larson, J. M. (2024): Synthetic Replacements for Human Survey Data? The Perils of Large Language Models. Political Analysis 32(4), 401–416. https://doi.org/10.1017/pan.2024.5
Was das für Ihre Organisation heißt. Im KI-Organisationslabor klären wir es gemeinsam am echten Fall.
Im KI-Organisationslabor bringen wir Agenten in den echten Betrieb und legen fest, wer welche Entscheidung trifft. Vorher rechnen wir Szenarien in Euro durch.
Jeden Monat eine Einordnung zu KI in Organisationen.
Einmal im Monat nehme ich mir ein Thema vor, das Organisationen gerade beschäftigt. Sie bekommen das Editorial und die neuen Analysen per Mail. Die erste Ausgabe per Mail kommt im Dezember.
Aktuell Ausgabe 1 · November 2026 · Wer wirklich im KI-Loop steht. Ausgabe lesen ›