Künstliche Daten sollen aussehen wie echte Personaldaten und doch niemanden verraten. Ein Forschungsteam aus Lausanne und London hat dieses Versprechen 2022 auf die Probe gestellt. Für die Menschen, die aus der Reihe fallen, hielt es oft nicht.
 Prof. Dr. Kai Reinhardt17. November 2026 · 5 Min. Lesezeit
Kurz gesagt
Was sind Synthetic Data im Personalbereich? Synthetic Data sind künstlich erzeugte Datensätze. Ein Modell lernt aus echten Daten, wie sie verteilt sind, und erzeugt dann neue Datensätze mit ähnlichen Eigenschaften. Im Personalbereich verspricht man sich davon Auswertungen und Tests, ohne echte Beschäftigte preiszugeben. Theresa Stadler, Bristena Oprisanu und Carmela Troncoso haben dieses Versprechen 2022 auf der Fachkonferenz USENIX Security geprüft, allerdings an Patienten- und Bevölkerungsdaten. Ihr Ergebnis: Synthetic Data schützen entweder nicht zuverlässig vor Angriffen auf die Privatsphäre oder sie verlieren an Nutzen. Einen besseren Kompromiss als die klassische Anonymisierung fanden sie nicht. Besonders gefährdet waren Datensätze von Menschen, die aus der Reihe fallen. Für Personaldaten ist das eine Übertragung.
Ein Forschungsteam nimmt sich öffentliche Krankenhausdaten aus Texas vor. Daraus wählt es 5 Patienten aus, die auffallen. 2 haben sehr hohe Behandlungskosten, einer sehr hohe Kosten, die keine Versicherung übernommen hat, und 2 ein ungewöhnlich hohes Sterberisiko bei schwerer Erkrankung. Dann erzeugt das Team aus den echten Daten künstliche Daten und spielt den Angreifer. Kann man aus den künstlichen Daten erschließen, ob einer dieser 5 Menschen in den Originaldaten war? Bei mehreren gelingt das gut. Bei einem der Verfahren bekommt einer der 5 so gut wie keinen Schutz.
Was sind Synthetic Data?
Synthetic Data sind künstlich erzeugte Datensätze. Man kann sich das wie bei einer Kunststudentin vorstellen, die kein Bild kopiert. Sie studiert viele Bilder eines Malers und malt dann neue im selben Stil. Genauso lernt ein Modell aus echten Daten, wie die Werte verteilt sind und wie sie zusammenhängen. Danach erzeugt es neue Datensätze. Keine Zeile entspricht direkt einer echten Person.
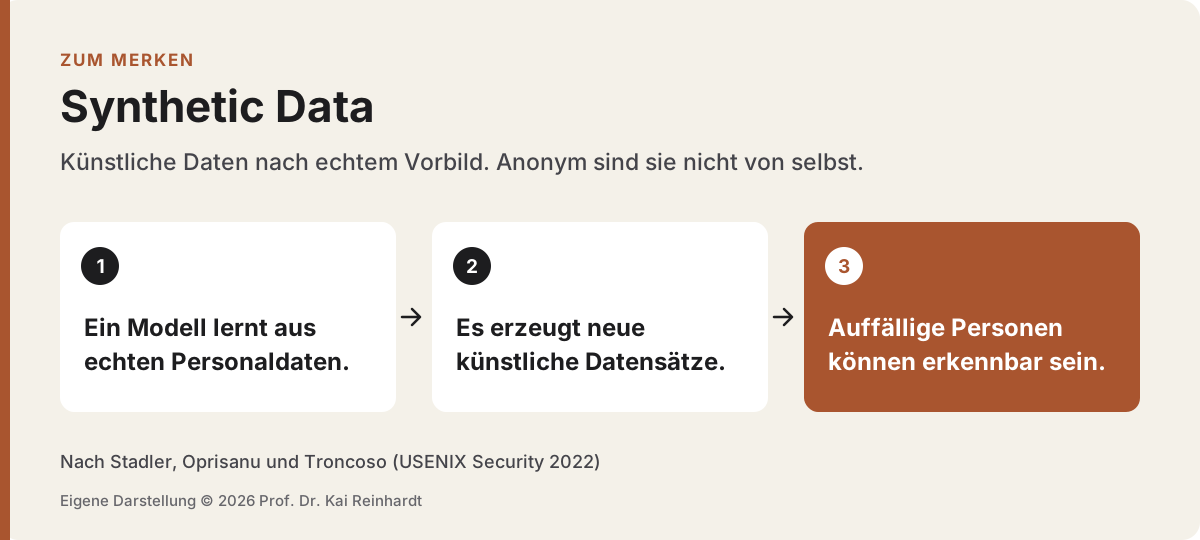
Für den Personalbereich klingt das verlockend. Man könnte Gehaltsstrukturen, Fehlzeiten oder Laufbahnen auswerten oder neue Software testen, ohne echte Beschäftigte preiszugeben. Das Versprechen lautet sinngemäß, die Statistik bleibt und die Personen verschwinden.
Was hat die Studie herausgefunden?
Die Szene oben stammt aus einer Studie von Theresa Stadler, Bristena Oprisanu und Carmela Troncoso. Die 3 forschten an der EPFL in Lausanne und am University College London. Sie stellten ihre Arbeit 2022 auf der USENIX Security vor, einer begutachteten Fachkonferenz zur IT-Sicherheit. Der Titel spielt auf den Film „Und täglich grüßt das Murmeltier“ an. Das passt zu ihrer Einleitung. Dort halten sie fest, dass Versuche, Einzeldaten zu anonymisieren, bisher immer wieder gescheitert sind.
Die Forschenden prüften mehrere gängige Verfahren an 2 Datensätzen, den Krankenhausdaten aus Texas und einem US-Bevölkerungsdatensatz. Was fanden sie?
Erstens schützten Verfahren ohne eingebaute Schutzgarantie die Ausreißer nicht. Zufällig ausgewählte, unauffällige Datensätze waren fast vollständig geschützt. Die auffälligen dagegen blieben oft angreifbar.
Zweitens schützten Verfahren mit Differential Privacy besser. Das ist eine mathematische Garantie, die den Einfluss jedes einzelnen Datensatzes begrenzt. Der Preis war Genauigkeit. Ein Vorhersagemodell, trainiert auf den echten Daten, lag in einem Versuch bei 72,2 % Treffern. Mit klassisch anonymisierten Daten waren es 70,5 %, mit synthetischen Daten 68,0 % und mit der geschützten Variante nur noch 62,0 %. Bei einfachen Durchschnittswerten wichen die synthetischen Daten teils um ein Vielfaches ab.
Drittens ließ sich nicht vorhersagen, wen es trifft. Welche Person angreifbar blieb, hing vom Verfahren ab und davon, welche Merkmale ein Angreifer nutzte. Dazu kam ein Befund aus der Praxis. In 2 verbreiteten Umsetzungen geschützter Verfahren fanden die Forschenden Fehler, die den versprochenen Schutz unterliefen.
Ihr Fazit ist deutlich. Synthetic Data seien weit entfernt vom heiligen Gral der datenschutzfreundlichen Veröffentlichung.
Was heißt das für Personaldaten?
Ab hier übertrage ich. Die Studie hat Patienten- und Bevölkerungsdaten untersucht, keine Personaldaten.
Ich vermute Folgendes. In Personaldaten ist das Problem eher größer. Ein Ausreißer ist dort schnell gefunden. Es ist die einzige Frau in einer Führungsrunde, der einzige Mitarbeiter über 60 in einem kleinen Team oder die Person mit der seltenen Arbeitszeitregelung. In einer kleinen Abteilung ist fast jeder ein Ausreißer. Wer die Abteilung kennt, bringt das Wissen für einen Angriff schon mit. Das ist meine Deutung, gemessen hat die Studie das nicht.
Gerade die Menschen, die am meisten Schutz brauchen, fallen in künstlichen Daten am ehesten auf.
Natürlich bin ich kein Jurist. Ob synthetische Personaldaten rechtlich als anonym gelten, kann ich nicht beurteilen. Als Organisationsforscher halte ich mich an den Rat der Studie selbst. Wer Daten weitergibt, sollte Nutzen und Risiko für den eigenen Zweck prüfen.
Was bedeutet das für eine synthetische Organisation?
Eine synthetische Organisation ist in meinem Rahmen ein Modell einer Organisation aus KI-Agenten, synthetischen Personas und künstlichen Daten. Daran probiert man Struktur, Rollen und Entscheidungsrechte aus. Meine Prüfschleife dafür hat 4 Schritte: Abbilden, Besetzen, Durchspielen und Abgleichen.
Künstliche Daten kommen im 2. Schritt ins Spiel, beim Besetzen. Dort bekommen Agenten und Personas ihr Wissen. Die Studie gibt dafür 2 Hinweise. Künstliche Daten sind kein Freifahrtschein für den Datenschutz. Und sie können die Statistik verzerren, auf die sich das Modell stützt. Dann zeigt das Durchspielen Engpässe, die es so nicht gibt. Beides muss im 4. Schritt mit echten Zahlen abgeglichen werden.
Synthetic Persona → Organizational Digital Twin →
Vielleicht nehmen Sie 3 Fragen mit. Wo werden in Ihrer Organisation schon künstliche Daten erzeugt oder eingekauft? Wer in Ihren Personaldaten wäre ein Ausreißer, den man auch in künstlichen Daten wiedererkennt? Und wer prüft, ob die künstlichen Daten für den Zweck überhaupt genau genug sind?
Alle Begriffe rund um die synthetische Organisation stehen im Dossier Synthetische Organisation. Warum künstliche Befragte die Vielfalt echter Gruppen glätten, beschreibt der Beitrag zum Flattening.
Quellen
Stadler, T./Oprisanu, B./Troncoso, C. (2022): Synthetic Data – Anonymisation Groundhog Day. Proceedings of the 31st USENIX Security Symposium, 1451–1468. https://www.usenix.org/conference/usenixsecurity22/presentation/stadler
Was das für Ihre Organisation heißt. Im KI-Organisationslabor klären wir es gemeinsam am echten Fall.
Im KI-Organisationslabor bringen wir Agenten in den echten Betrieb und legen fest, wer welche Entscheidung trifft. Vorher rechnen wir Szenarien in Euro durch.
Jeden Monat eine Einordnung zu KI in Organisationen.
Einmal im Monat nehme ich mir ein Thema vor, das Organisationen gerade beschäftigt. Sie bekommen das Editorial und die neuen Analysen per Mail. Die erste Ausgabe per Mail kommt im Dezember.
Aktuell Ausgabe 1 · November 2026 · Wer wirklich im KI-Loop steht. Ausgabe lesen ›