27 Radiologen, 50 Mammogramme und eine KI, die manchmal falsch einstuft. Eine Leserstudie aus der Radiologie zeigt, was im Menschen passiert, wenn er die Arbeit einer KI prüfen soll. Der Befund betrifft jede Organisation, die Vorschläge eines Agenten von Fachleuten freigeben lässt.
 Prof. Dr. Kai Reinhardt14. November 2026 · 11 Min. Lesezeit
Kurz gesagt
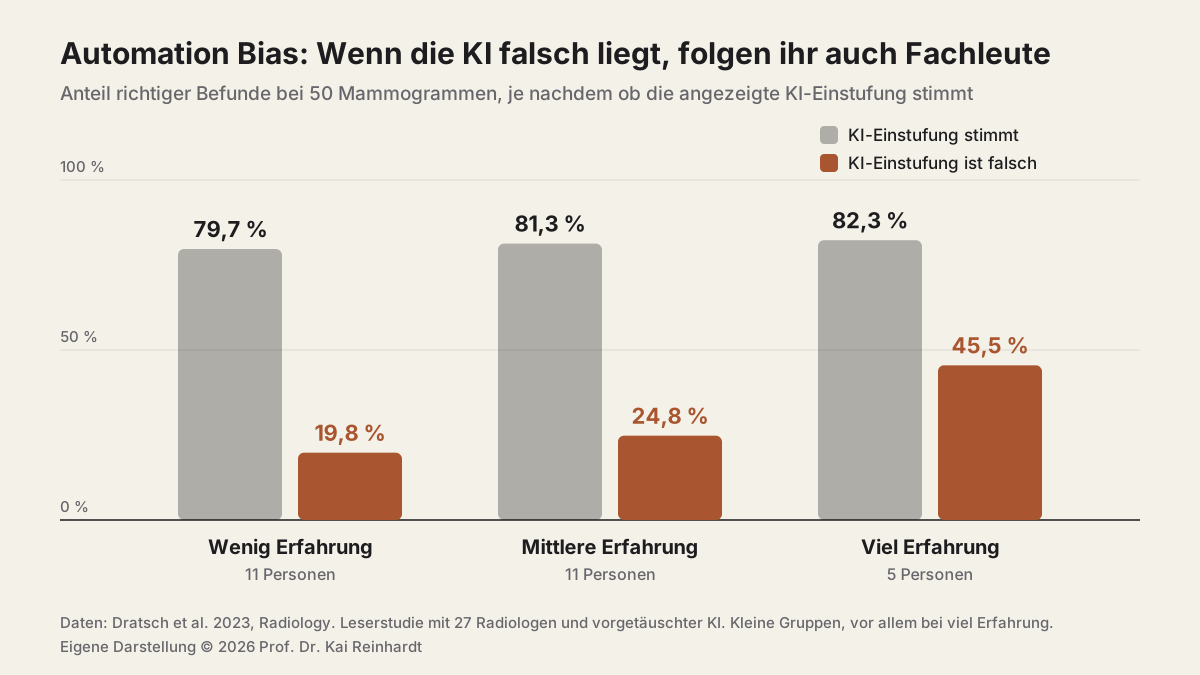
Erkennen erfahrene Fachleute die Fehler einer KI? Nur zum Teil. In einer Leserstudie in „Radiology“ (Dratsch et al. 2023) bewerteten 27 Radiologen 50 Mammogramme. Bei richtiger KI-Einstufung lagen sehr erfahrene Radiologen in 82,3 % der Fälle richtig, bei falscher nur in 45,5 %. Unerfahrene fielen von 79,7 % auf 19,8 %. Die Werte stehen im Abstract der Studie. Die Gruppe der sehr Erfahrenen umfasste 5 Personen. Die Forschung nennt diese Neigung Automation Bias. Erfahrung dämpft sie, hebt sie aber nicht auf. Ein nicht begutachtetes Feldexperiment deutet darauf hin, dass eine bessere KI die Prüfmühe senkt. Experimente zur Schuldzuschreibung zeigen, dass die Schuld für Fehler trotzdem beim Menschen landet. Wirksam ist nach heutigem Stand vor allem die Gestaltung der Freigabe, etwa wenn Prüfende erst selbst urteilen und danach den Vorschlag der KI sehen.
Ein Radiologe sitzt vor der Röntgenaufnahme einer Brust. Er soll entscheiden, ob das Bild unauffällig ist oder ob die Patientin weiter untersucht werden muss. Neben der Aufnahme steht schon eine Einschätzung, die angeblich eine KI abgegeben hat. Der Radiologe weiß nicht, dass diese Einschätzung in Wahrheit von den Forschern stammt und bei einem Teil der Aufnahmen falsch ist. Der Versuch soll zeigen, ob er das merkt.
Was in der Studie passierte.
Schauen wir uns an, was in der Studie passierte. 27 Radiologen haben auf diese Weise je 50 Aufnahmen beurteilt. Solange die Einschätzung neben dem Bild stimmte, lief alles gut. Die Radiologen lagen dann in rund 80 % der Fälle richtig, und zwar fast unabhängig davon, wie lange sie schon im Beruf waren.
War die Einschätzung falsch, kippte das Ergebnis.
Die Radiologen mit wenig Erfahrung lagen nur noch in 19,8 % der Fälle richtig, also bei etwa 1 von 5 Aufnahmen. Die mittlere Gruppe kam auf 24,8 %. Die Radiologen mit der meisten Erfahrung lagen in 45,5 % der Fälle richtig. Auch sie haben also bei mehr als jeder zweiten dieser Aufnahmen falsch entschieden. Das waren keine Laien. Es waren Menschen, deren Beruf es ist, genau solche Bilder zu beurteilen. Sie hatten aber ein fertiges Urteil vor Augen, bevor sie ihr eigenes gebildet hatten. Dieses fertige Urteil hat ihr eigenes in vielen Fällen ersetzt.
Veröffentlicht haben die Studie Dratsch und Kollegen 2023 in der Fachzeitschrift „Radiology“. Die Arbeit ist begutachtet, der Erstautor arbeitet an der Uniklinik Köln. Stimmte die Einschätzung, lagen die 3 Gruppen bei 79,7 %, 81,3 % und 82,3 %. Viel Praxis und wenig Praxis unterscheiden sich in diesen Daten also erst, wenn die KI danebenliegt.
Für dieses Muster gibt es einen Namen. Die Forschung nennt es Automation Bias.
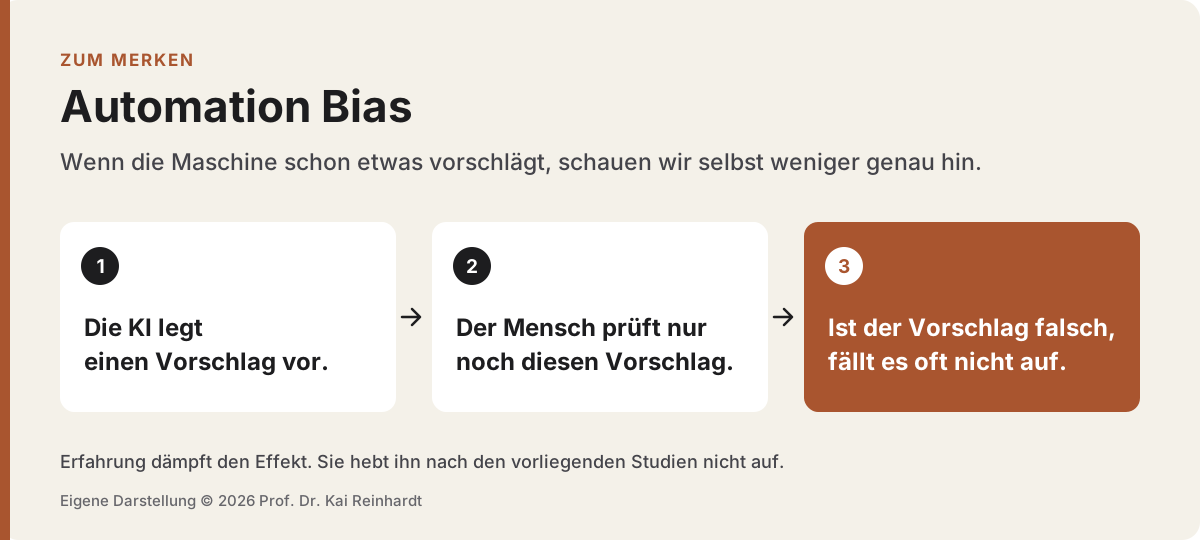
Gemeint ist die Neigung, die Empfehlung eines automatisierten Systems zu übernehmen und die eigene Prüfung zu unterlassen.
Wie belastbar ist das? Die Studie hat Grenzen, und sie gehören zum Befund. 27 Personen sind eine kleine Stichprobe. Die Gruppe mit der meisten Erfahrung bestand aus 5 von ihnen, die beiden anderen Gruppen aus je 11. Außerdem war die KI vorgetäuscht. Die Radiologen saßen also in einem Versuch und nicht in ihrem Klinikalltag.
Schützt Erfahrung vor dem Fehler der KI?
Die naheliegende Hoffnung lautet, dass erfahrene Leute so etwas merken. Die Zahlen geben ihr nur zum Teil recht. Erfahrung hilft, weil 45,5 % deutlich mehr sind als 19,8 %. Sie reicht aber nicht, weil auch die Erfahrensten in mehr als der Hälfte dieser Fälle falsch lagen.
Woran könnte das liegen? Ich vermute Folgendes. Wer ein fertiges Urteil vor sich sieht, bevor er ein eigenes gebildet hat, prüft das fremde Urteil und bildet kein eigenes mehr. Das sind zwei verschiedene Tätigkeiten. Beim Prüfen suche ich nach Gründen, warum der Vorschlag nicht stimmt. Finde ich keine, stimme ich zu. Das ist eine Deutung der Daten, die Studie selbst hat diesen Ablauf im Kopf nicht gemessen.
Eine Befragung von Wissensarbeitern weist in dieselbe Richtung. Lee und Kollegen berichten 2025 zwei Zusammenhänge. Wer der KI stärker vertraut, prüft weniger kritisch. Wer der eigenen Kompetenz stärker vertraut, prüft mehr. Die Befragten haben das über sich selbst angegeben, deshalb sind diese Daten schwächer als ein Experiment.
Erfahrung macht das eigene Urteil besser. Vor dem Vorschlag, der schon auf dem Bildschirm steht, schützt sie nach diesen Daten nur zur Hälfte.
Was hat das mit einem Büro zu tun? Viele Freigaben sind genauso gebaut wie dieser Versuch. Eine Sachbearbeiterin sieht den Bescheid, den ein KI-Agent vorbereitet hat. Ein Einkäufer sieht die Lieferantenauswahl. Eine Personalerin sieht die Vorauswahl der Bewerbungen. In jedem dieser Fälle liegt das fremde Urteil zuerst auf dem Tisch, und die Person soll nur noch bestätigen. Hier ist allerdings Vorsicht nötig. Die Übertragung von der Radiologie auf das Büro ist ein Analogieschluss. Fast alle starken Befunde stammen aus Systemen, die einzelne Empfehlungen geben. Zu Agenten, die mehrere Arbeitsschritte selbst ausführen, fehlen noch belastbare Studien.
Einen ersten Hinweis gibt es. Dissanayake und Kollegen ließen 2026 in einer noch nicht begutachteten Studie 36 Personen mit Programmierkenntnissen die Arbeit eines Programmier-Agenten abnehmen. Die Studie heißt „Looks Fine to Me“, auf Deutsch etwa: Sieht für mich gut aus. In 43 Fällen übersahen die Teilnehmenden einen Fehler des Agenten. In 34 davon gaben sie trotzdem an, sich ziemlich oder sehr sicher zu sein, dass das Ergebnis stimmt.
Ich habe das Muster in diesem November an mir selbst beobachtet. Für meine Website arbeitet ein Team aus KI-Agenten, das neue Themen recherchiert und Änderungen an der Seite vorbereitet. Aus ein paar diktierten Bemerkungen von mir hatte dieses Team eine Seite neu aufgebaut. In der Beschreibung las sich das schlüssig, und ich hatte der Richtung schon zugestimmt. Erst als ich die Seite in der Vorschau vor mir sah, fiel mir auf, dass sie denselben Ablauf zweimal erklärte, einmal oben und einmal unten. Die Gedanken stammten von mir, den Aufbau hatte ich nie geprüft. Ich bin Organisationsforscher und beschäftige mich seit Jahren mit Entscheidungsrechten. Trotzdem hatte ich einem Vorschlag zugestimmt, weil er aus meinen eigenen Worten gebaut war und fertig aussah.
Wird das Problem mit besserer KI kleiner?
Man könnte meinen, dass sich das Problem von selbst erledigt, sobald die KI besser wird. Ein Feldexperiment von Dell’Acqua spricht dagegen. 181 professionelle Recruiter bewerteten darin Bewerbungen, zusammen knapp 8.000 Mal. Sie arbeiteten unter einer von 4 Bedingungen. Eine Gruppe bekam eine bessere KI, die in rund 85 % der Fälle richtig lag. Eine andere bekam eine schlechtere KI mit rund 75 %. Das Ergebnis überrascht zunächst. Die Recruiter mit der besseren KI urteilten ungenauer als die Recruiter mit der schlechteren. Der Grund lag in der Mühe. Wer die schlechtere KI hatte, nahm sich mehr Zeit und übernahm Empfehlungen seltener automatisch. Am stärksten zeigte sich der Effekt bei den erfahrenen Recruitern.
Zwei Vorbehalte gehören dazu. Die Arbeit ist ein Arbeitspapier und noch nicht von Fachkollegen begutachtet. Außerdem zeigt sie nicht, dass die Recruiter schlechter waren als ganz ohne KI. Belegt ist nur der Vergleich der beiden Gruppen. Für eine unbequeme Einsicht reicht er trotzdem.
Je verlässlicher ein System wirkt, desto weniger lohnt sich das Nachprüfen aus Sicht der Person, die prüfen soll.
Neu ist dieser Zusammenhang nicht. Schon 1993 ließen Parasuraman, Molloy und Singh Versuchspersonen eine Automatik überwachen, während sie nebenbei andere Aufgaben erledigten. Arbeitete die Automatik gleichbleibend zuverlässig, bemerkten die Versuchspersonen im Mittel nur 33 % ihrer Fehler. Schwankte die Zuverlässigkeit, bemerkten sie 82 %. Die beiden Werte stammen aus einer späteren Übersichtsarbeit von Parasuraman und Manzey. Das Experiment war klein, mit 40 Versuchspersonen.
Die Forscherin Lisanne Bainbridge hat dafür 1983 einen Titel gefunden, der bis heute zitiert wird: die Ironien der Automatisierung. Automatisierung nimmt dem Menschen die Routine ab. Die Verantwortung für die Ausnahmefälle, mit denen die Technik nicht zurechtkommt, bleibt bei ihm.
Dazu passt eine große Auswertung vieler Studien. Vaccaro, Almaatouq und Malone haben 2024 in „Nature Human Behaviour“ 106 Experimente zusammengefasst. Zuerst die gute Nachricht. Mensch und KI zusammen waren im Mittel besser als der Mensch allein. Sie waren aber schlechter als der Bessere von beiden allein. Am deutlichsten war dieser Verlust bei Entscheidungsaufgaben, also dort, wo jemand zwischen festen Möglichkeiten wählen muss. Eine Freigabe ist aus meiner Sicht genau so eine Aufgabe. Die Experimente enden Mitte 2023 und betreffen überwiegend klassische Entscheidungshilfen. Generative KI und Agenten kommen darin kaum vor.
Folgen Menschen einer KI also blind? So einfach ist es nicht. Alon-Barkat und Busuioc fanden 2023 in 3 Survey-Experimenten in den Niederlanden keinen Beleg für einen generellen Automation Bias. 2 Experimente liefen mit Bürgerinnen und Bürgern, 1 mit Beamten. Der Rat eines Algorithmus wurde nicht stärker befolgt als der gleichwertige Rat von Experten.
Die Studie fand noch etwas anderes. In einem der Experimente folgten die Teilnehmenden einem Rat eher, wenn er zu verbreiteten Vorurteilen über eine Gruppe passte. Das galt für den Rat des Algorithmus genauso wie für den Rat eines Menschen. Im Experiment mit den Beamten zeigte es sich nicht. Die KI macht ein Urteil also nicht von selbst unvoreingenommen.
Genauer als „blinder Gehorsam“ ist deshalb ein anderer Satz.
Menschen schätzen häufig falsch ein, wie verlässlich eine KI ist.
Wer bekommt die Schuld für den Fehler?
Wenn Menschen schlechter prüfen, als ihre Organisation annimmt, müsste auch die Verantwortung anders verteilt werden. Die Experimente zeigen das Gegenteil. Elish hat dafür 2019 den Begriff Moral Crumple Zone geprägt. Wörtlich ist das eine moralische Knautschzone. Beim Auto fängt die Knautschzone den Aufprall ab. In der Organisation fängt der Mensch am Bedienpult die Schuld ab, wenn ein automatisiertes System versagt. Das geschieht auch dann, wenn er nur begrenzte Kontrolle hatte. Arnestad, Meyers, Gray und Bigman haben das 2024 in der Zeitschrift „Cognition“ in Experimenten gezeigt. Schon die bloße Möglichkeit, von Hand einzugreifen, erhöht die Schuld, die dem Menschen bei einem Fehler der KI zugeschrieben wird. Das gilt auch dann, wenn er weder die Zeit noch die Fähigkeit zum Eingreifen hatte.
Was heißt das für einen Freigabeknopf? Er ist kein neutrales Bauteil.
Er macht die Person, die ihn drückt, in den Augen anderer zur Verursacherin. Das gilt auch, wenn sie den Fehler realistisch kaum erkennen konnte. Diese Verbindung ist meine Folgerung aus mehreren Studien und kein einzeln gemessener Effekt. Die Experimente messen außerdem, wem Versuchspersonen in beschriebenen Fällen die Schuld geben. Über Arbeitsrecht oder Haftung sagen sie nichts.
Was das Wort Mitarbeiter mit der Prüfung macht.
Manche Organisationen führen ihre KI-Agenten inzwischen im Organigramm, als wären sie Kollegen. Macht das einen Unterschied? Ein Experiment von Wiles, Hsu, Bedard und Kropp deutet darauf hin. 1.261 Manager aus Personal und Finanzen bekamen identische Dokumente mit eingebauten Fehlern. Verändert wurde nur die Angabe, von wem das Dokument stammt. Zur Wahl standen ein KI-Tool, ein „KI-Mitarbeiter“ und ein Mensch.
Interessant sind die Manager aus Organisationen, die Agenten im Organigramm führen. Das war knapp ein Viertel der Befragten. Stand bei ihnen „KI-Mitarbeiter“ statt „KI-Tool“ auf dem Dokument, sank der Anteil der entdeckten Fehler um 17 %. Sie baten um 22 Prozentpunkte häufiger andere um eine zusätzliche Prüfung. Ihre gefühlte eigene Verantwortung sank um rund 9 Prozentpunkte, die dem KI-System zugeschriebene stieg um 8.
Auch hier sind die Einschränkungen erheblich, und die Autoren nennen sie selbst. Die Arbeit ist ein Arbeitspapier von 2026 und nicht begutachtet. Im Durchschnitt aller Befragten waren die Effekte klein. Die Auswertung nach Organigramm war zudem nicht die, die vorab registriert war. Der Befund ist deshalb ein Hinweis und kein gesichertes Ergebnis. Zusammen mit Arnestad und Kollegen ergibt sich allerdings ein ungutes Bild. Außenstehende geben der prüfenden Person mehr Schuld, während sie selbst sich weniger verantwortlich fühlt.
Was können Organisationen tun?
Der erste Reflex ist ein Appell. Die Leute sollen eben aufpassen.
Auch Art. 14 der europäischen KI-Verordnung beschreibt für Hochrisiko-Systeme, dass Aufsichtspersonen sich der Neigung zum übermäßigen Vertrauen bewusst bleiben sollen. Die Verordnung nennt diese Neigung „Automatisierungsbias“. Bewusstsein allein schützt aber kaum. Parasuraman und Manzey kommen 2010 in ihrer Übersicht über die Forschung zu dem Schluss, dass sich Automation Bias durch Training oder Anweisungen nicht verhindern lässt. Wirksamer ist es, den Ablauf anders zu bauen.
Auch ein zweiter Prüfer löst das Problem nicht von selbst. Skitka und Kollegen verglichen 2000 Zweierteams mit Einzelpersonen. Die Teams übersahen Fehler der Automatik genauso häufig und folgten falschen Anweisungen genauso häufig. Ich lese das als Warnung, sich beim Prüfen von KI-Arbeit nicht allein auf das Vier-Augen-Prinzip zu verlassen.
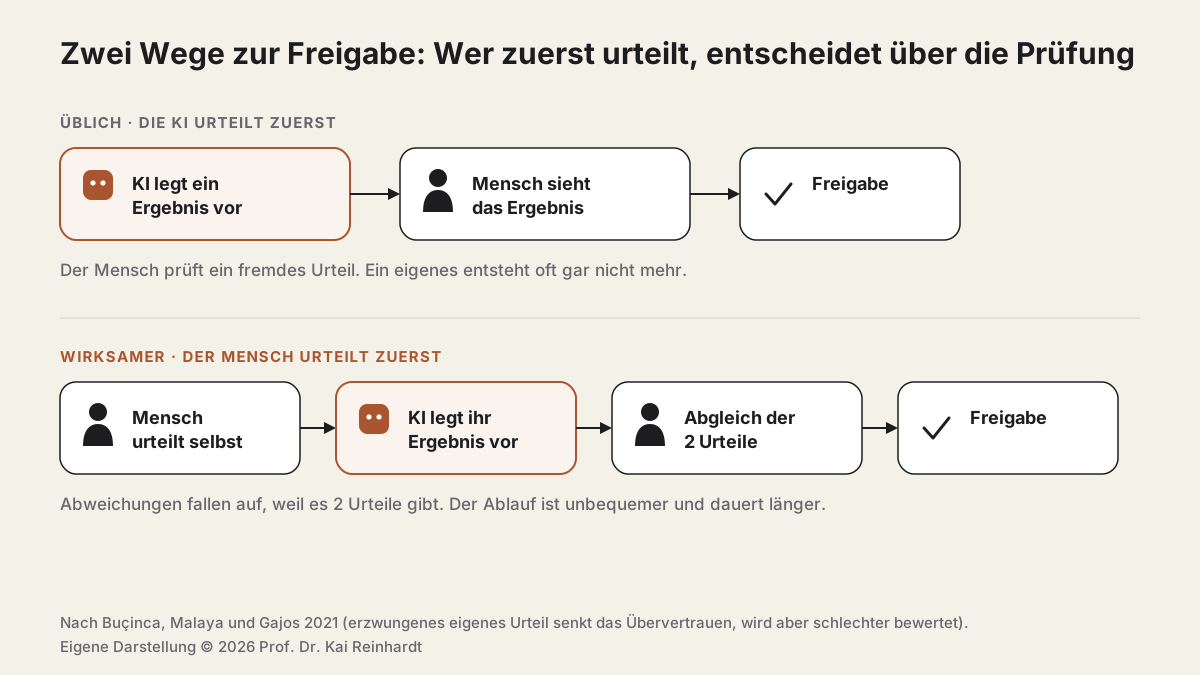
Was hilft dann? Abläufe, die die prüfende Person dazu bringen, erst selbst nachzudenken.
Stellen Sie sich eine Sachbearbeiterin vor, die einen Bescheid freigeben soll. Im üblichen Ablauf sieht sie sofort, was die KI vorschlägt. Im geänderten Ablauf trägt sie zuerst ihre eigene Einschätzung ein. Erst danach wird der Vorschlag der KI eingeblendet. Sie hat dann 2 Urteile vor sich und merkt, wenn sie nicht zusammenpassen.
Solche Abläufe haben Buçinca, Malaya und Gajos 2021 in einem Experiment mit 199 Teilnehmenden getestet. Es gab 3 Varianten. In der ersten mussten die Teilnehmenden erst selbst entscheiden und sahen den Vorschlag der KI danach. In der zweiten erschien der Vorschlag erst nach einer Wartezeit. In der dritten gab es ihn nur auf Abruf. Verglichen wurde mit Abläufen, in denen die KI ihren Vorschlag sofort zeigt und erklärt.
Mit den 3 Varianten verließen sich die Teilnehmenden nachweislich seltener auf falsche Vorschläge. Ganz verschwunden ist der Effekt nicht.
Dazu kommt ein Haken. Die Varianten, die am besten schützten, wurden von den Teilnehmenden am schlechtesten bewertet. Ich vermute, weil sie mehr Mühe machen. Wer eine Freigabe so umbaut, sollte deshalb mit Widerstand rechnen und den Grund vorher erklären.
Die zweite Bedingung betrifft den Aufwand. Vasconcelos und Kollegen haben 2023 in 5 Studien mit zusammen 731 Teilnehmenden untersucht, wann die Erklärungen einer KI helfen. Sie helfen dann, wenn Prüfen dadurch spürbar weniger Mühe macht als Durchwinken. Daraus leite ich eine Regel für Agenten ab, die über die Studien hinausgeht. Der Freigabeschritt sollte Belege und Abweichungen so zeigen, dass sie schneller zu erfassen sind als das Ergebnis selbst.
Die dritte Bedingung ist die Begründung. Skitka, Mosier und Burdick zeigten 2000 in einem Experiment, was Rechenschaft bewirkt. Wer wusste, dass er später für die Richtigkeit seiner Entscheidungen einstehen muss, verließ sich seltener ungeprüft auf die Automatik. Für eine Freigabe könnte das heißen, dass die prüfende Person in einem Satz festhält, warum sie zustimmt. Das ist meine Übertragung, in dieser Form getestet wurde es nicht.
Auch dafür habe ich ein eigenes Beispiel. Mein Agenten-Team meldete mir, eine geänderte Seite gehe am nächsten Tag live, falls ich nicht widerspreche. Neben der Meldung stand ein Knopf mit dem Wort „Stopp“. Einen Link zur geänderten Seite gab es nicht. Ich konnte also zustimmen oder blind stoppen, und Prüfen war in diesem Ablauf der teuerste Weg. Wir haben das am selben Tag geändert. Jede Ankündigung enthält jetzt die Vorschau der Seite, und wichtige Seiten gehen erst nach meinem Ja live.
Was ich daraus mitnehme.
Natürlich sind das zunächst alles nur Annahmen, denn ich bin kein Psychologe. Was im Kopf eines Radiologen vorgeht, wenn die Einschätzung der KI schon neben dem Bild steht, kann ich nicht beurteilen. Ich bin Organisationsforscher. Aber genau aus dieser Sicht steckt in den Befunden eine gute Nachricht. Wenn das Problem nur in den Köpfen läge, könnten Organisationen wenig tun. Es liegt aber auch im Ablauf, und einen Ablauf kann man ändern.
Wir verlangen heute von Fachleuten, dass sie die KI beaufsichtigen. Die Bedingungen, unter denen das möglich ist, gestalten wir meist nicht. Eine Organisation kann aber festlegen, wer zuerst urteilt, was diese Person dabei sieht und wie viel Aufwand die Prüfung kostet. Ich nenne das die Entscheidungsarchitektur einer Organisation, und die Freigabe gehört für mich dort hinein. Gemessen habe ich das nicht. Es ist meine Einschätzung aus der Arbeit mit Organisationen und aus dem Betrieb meines eigenen Agenten-Teams.
Aus den Studien nehme ich 4 Dinge mit, die eine Organisation selbst in der Hand hat.
- Erst das eigene Urteil: Die prüfende Person legt sich fest, bevor sie den Vorschlag der KI sieht.
- Prüfen muss leichter sein als Durchwinken: Belege und Abweichungen stehen so da, dass man sie schnell erfassen kann.
- Eine kurze Begründung: Wer freigibt, hält in einem Satz fest, warum.
- Übung ohne KI: Fachleute bearbeiten regelmäßig Fälle ganz ohne Vorschlag, damit ihr eigenes Urteil nicht einrostet. Das ist die Folgerung, die am wenigsten durch Experimente gedeckt ist.
Vielleicht nehmen Sie aus diesem Beitrag 3 Fragen mit. Wo in Ihrer Organisation liegt das Urteil einer KI schon auf dem Tisch, bevor ein Mensch selbst geurteilt hat? Wie viel Mühe kostet es dort, den Vorschlag wirklich zu prüfen? Wer bekommt die Schuld, wenn der Vorschlag falsch war und trotzdem freigegeben wurde?
Wer die Prüfung von KI-Arbeit an erfahrene Leute übergibt, hat damit noch keine wirksame Kontrolle eingerichtet.
Woher der Begriff der menschlichen Aufsicht kommt, beschreibt der Grundlagenbeitrag Human in the Loop: Woher der Begriff kommt und was er verlangt. Die Aufsichtslast bei eigenständig arbeitenden Agenten behandelt Human in the Loop: Warum Delegation keine Zusammenarbeit ist. Wenn Sie Freigaben für Ihre eigene Organisation durchdenken möchten, ist das KI-Organisationslabor der Ort dafür.
Quellen
Alon-Barkat, S./Busuioc, M. (2023): Journal of Public Administration Research and Theory (JPART), 3 Survey-Experimente. arXiv-Fassung: https://arxiv.org/abs/2103.02381v3
Arnestad/Meyers/Gray/Bigman (2024): Cognition. Nachweis im Forschungsportal der Hebrew University: https://cris.huji.ac.il/en/publications/the-existence-of-manual-mode-increases-human-blame-for-ai-mistake-2/
Bainbridge, L. (1983): Ironies of Automation. Automatica 19(6), 775–779. https://www.sciencedirect.com/science/article/abs/pii/0005109883900468
Buçinca/Malaya/Gajos (2021): CSCW 2021, N = 199. https://arxiv.org/pdf/2102.09692
Dell’Acqua, F.: Falling Asleep at the Wheel. Working Paper, nicht begutachtet, 181 Recruiter. Zusammenfassung beim Digital Data Design Institute der Harvard Business School: https://d3.harvard.edu/?p=30560
Dissanayake et al. (2026): Looks Fine to Me. Preprint, nicht begutachtet, 36 Teilnehmende. https://arxiv.org/abs/2610.27801
Dratsch et al. (2023): Radiology, 27 Radiologen, 50 Mammogramme. Zahlen nach dem Abstract: https://pubs.rsna.org/doi/10.1148/radiol.222176
Elish (2019): Moral Crumple Zones. https://just-tech.ssrc.org/?p=10306
Lee et al. (2025): CHI 2025, Befragung von Wissensarbeitern, Selbstauskunft. https://advait.org/files/lee_2025_ai_critical_thinking_survey.pdf
Parasuraman/Manzey (2010): Human Factors 52(3), 381–410, Übersichtsarbeit. https://doi.org/10.14279/depositonce-8052
Parasuraman/Molloy/Singh (1993): International Journal of Aviation Psychology 3(1), 1–23, 40 Versuchspersonen in 2 Experimenten. https://doi.org/10.1207/s15327108ijap0301_1
Skitka/Mosier/Burdick (2000): International Journal of Human-Computer Studies 52(4), 701–717. https://doi.org/10.1006/ijhc.1999.0349
Skitka/Mosier/Burdick/Rosenblatt (2000): International Journal of Aviation Psychology 10(1), 85–97. https://pubmed.ncbi.nlm.nih.gov/11543300/
Vaccaro/Almaatouq/Malone (2024): Nature Human Behaviour, 106 Experimente. https://pmc.ncbi.nlm.nih.gov/articles/PMC11659167/
Vasconcelos et al. (2023): CSCW 2023, N = 731 über 5 Studien. https://arxiv.org/abs/2212.06823
Verordnung (EU) 2024/1689 (KI-Verordnung), Art. 14. https://artificialintelligenceact.eu/article/14/
Wiles/Hsu/Bedard/Kropp (2026): Working Paper, nicht begutachtet, 1.261 HR- und Finance-Manager. https://emmawiles.com/storage/ai_employee.pdf
Was das für Ihre Organisation heißt. Im KI-Organisationslabor klären wir es gemeinsam am echten Fall.
Im KI-Organisationslabor bringen wir Agenten in den echten Betrieb und legen fest, wer welche Entscheidung trifft. Vorher rechnen wir Szenarien in Euro durch.
Jeden Monat eine Einordnung zu KI in Organisationen.
Einmal im Monat nehme ich mir ein Thema vor, das Organisationen gerade beschäftigt. Sie bekommen das Editorial und die neuen Analysen per Mail. Die erste Ausgabe per Mail kommt im Dezember.
Aktuell Ausgabe 1 · November 2026 · Wer wirklich im KI-Loop steht. Ausgabe lesen ›