Ein Sprachmodell soll 7.530 echte Befragte nachspielen. Die Durchschnitte passen erstaunlich gut. Dann rechnen die Forscher nach, wer warum so antwortet. Fast die Hälfte der Zusammenhänge stimmt nicht. Wer eine Organisation simulieren will, sollte diese Grenzen kennen, bevor er den Ergebnissen glaubt.
 Prof. Dr. Kai Reinhardt17. November 2026 · 10 Min. Lesezeit
Kurz gesagt
Was sieht die Simulation einer Organisation nicht? Synthetische Personas und KI-Agenten haben belegte Schwächen. Sprachmodelle halten Menschen für rationaler, als sie entscheiden (Liu et al. 2025). Sie zeigen weniger Vielfalt innerhalb einer Gruppe als echte Menschen, die Forschung nennt das Flattening (Wang et al., Santurkar et al. 2023). In Gruppen passen sich Agenten der Mehrheit an, auch gegen eigenes besseres Wissen (Weng et al. 2025). Mittelwerte stimmen oft, Zusammenhänge zwischen Merkmalen und Antworten dagegen häufig nicht (Bisbee et al. 2024). Implizites Wissen, das Menschen nicht aussprechen können, steht in keinem Prompt. Und synthetische Daten schützen persönliche Daten nicht automatisch (Stadler et al. 2022). Für eine synthetische Organisation heißt das: Erst der Abgleich mit echten Menschen zeigt, was ein Ergebnis wert ist.
Im April 2023 bekommt ChatGPT eine Rolle. Die Anweisung beginnt mit einem Jahr, einem Alter, einem Familienstand, einer Herkunft und einem Geschlecht. Dazu kommen Bildung, Einkommen, politische Haltung und Parteinähe. Dann soll die so beschriebene Person sagen, wie warm oder kalt sie gegenüber 11 Gruppen empfindet, etwa gegenüber Muslimen, Christen, Liberalen oder der Republikanischen Partei. Die Skala reicht von 0 für kalte bis 100 für warme Gefühle. Jede Beschreibung entspricht einem echten Menschen aus der großen amerikanischen Wahlstudie ANES. Für 7.530 dieser Menschen erzeugt das Modell je rund 30 synthetische Antworten.
Was die Forscher fanden.
Auf den ersten Blick ist das Ergebnis beeindruckend. Die Durchschnitte der künstlichen Befragten liegen nah an denen der echten. Auch die Reihenfolge der Gruppen stimmt weitgehend. So beschreiben es James Bisbee und Kollegen 2024 in der Fachzeitschrift „Political Analysis“.
Dann schauen sie genauer hin. Die künstlichen Antworten streuen viel weniger als die echten. Und sie prüfen Zusammenhänge, also etwa, wie stark Alter oder Parteinähe mit einer Antwort zusammenhängen. Bei 48 % dieser Zusammenhänge weicht das synthetische Ergebnis deutlich vom echten ab. Bei knapp 1 von 3 dieser Abweichungen zeigt der Zusammenhang sogar in die andere Richtung.
Dazu kommt ein dritter Befund. Dieselbe Anweisung lieferte im April, Juni und Juli 2023 unterschiedliche Verteilungen. Die Autoren führen das auf eine Aktualisierung des Modells im Juni zurück.
Der Durchschnitt stimmt also. Das Bild dahinter stimmt oft nicht.
Was hat das mit Organisationen zu tun?
Ich baue gerade einen Rahmen auf, den ich synthetische Organisation nenne. Gemeint ist ein Modell einer Organisation aus KI-Agenten, synthetischen Personas und künstlichen Daten. Daran probiert man Struktur, Rollen und Entscheidungsrechte aus, bevor man sie Menschen zumutet. Den Überblick gibt das Dossier Synthetische Organisation.
Ein solches Modell ist nur so gut wie seine Bausteine. Und für diese Bausteine gibt es inzwischen gute Forschung zu ihren Schwächen. Keine dieser Studien hat Organisationen untersucht. Sie haben Umfragen, Glücksspiele und Denkaufgaben untersucht. Die Übertragung auf einen Umbau ist mein Analogieschluss. Ich halte ihn aber für naheliegend, denn die Bausteine sind dieselben. Schauen wir uns 6 Grenzen an.
Grenze 1. Sprachmodelle halten Menschen für zu rational.
Stellen Sie sich eine einfache Wahl vor. Entweder 5 Dollar sicher oder eine Chance von 50 % auf 10 Dollar. Ryan Liu und Kollegen haben Sprachmodelle gefragt, wie Menschen bei fast 10.000 solcher Aufgaben wählen. Die echten Entscheidungen stammen aus einem großen Datensatz, jede Aufgabe haben mindestens 15 Menschen beantwortet. Die Studie erschien 2025 auf der Konferenz ICLR. Ihr Titel sagt das Ergebnis schon: Sprachmodelle nehmen an, dass Menschen rationaler sind, als wir wirklich sind.
Rational heißt hier, immer die Möglichkeit mit dem höchsten Erwartungswert zu wählen. Echte Menschen folgen dieser Regel nur mäßig, der Zusammenhang liegt bei 0,48. Die Vorhersagen von GPT-4o hingen mit der Regel zu 0,94 zusammen, wenn das Modell Schritt für Schritt nachdenken sollte. Das ist fast vollständig. Mit den echten Entscheidungen hingen sie nur bei rund 0,61 zusammen. Das Modell sagt also eher voraus, was ein Lehrbuch empfehlen würde, als was Menschen tun.
Einen verwandten Befund hatten Aher, Arriaga und Kalai schon 2023 auf der Konferenz ICML berichtet. Bei Schätzaufgaben gaben manche Modelle übergenau richtige Antworten, wo Menschen daneben liegen. Die Autoren nennen das „hyper-accuracy distortion“.
Warum Sprachmodelle Menschen für zu rational halten →
Was heißt das für einen Umbau? Ich vermute Folgendes. Synthetische Beschäftigte werden sich in einer Simulation eher so verhalten, wie das neue Organigramm es vorsieht. Sie lesen die Rollenbeschreibung und halten sich daran. Echte Menschen haben Gewohnheiten, Sorgen und Abkürzungen. Gemessen hat das für Organisationen noch niemand.
Grenze 2. Personas sind glatter als Menschen.
Die Forschung nennt das Flattening, also Abflachen. Eine Gruppe wirkt im Modell einheitlicher, als sie ist.
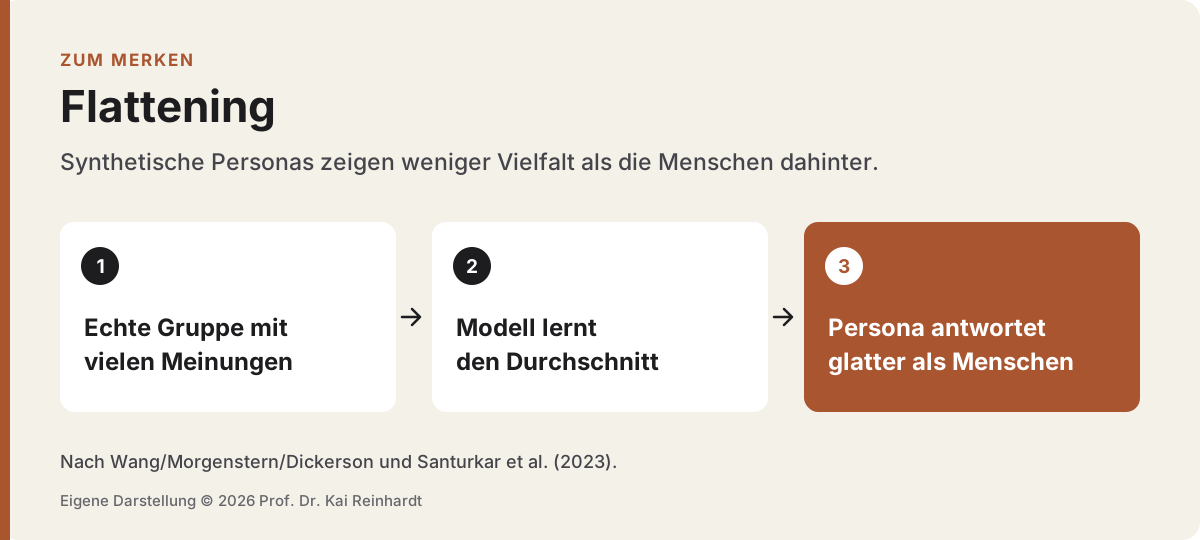
Angelina Wang, Jamie Morgenstern und John Dickerson haben das mit 3.200 Menschen aus 16 Gruppen und 4 Sprachmodellen untersucht. Die Modelle stellten Gruppen verzerrt und zu einheitlich dar. Gegenmittel beim Erstellen der Antworten verringerten das, beseitigten es aber nicht. Die Arbeit ist nach Angabe der Autoren zur Veröffentlichung in „Nature Machine Intelligence“ angenommen.
Schon 2023 hatten Shibani Santurkar und Kollegen Sprachmodelle mit Meinungsumfragen zu 60 amerikanischen Bevölkerungsgruppen verglichen. Einige Gruppen trafen die Modelle durchweg schlecht, etwa Menschen über 65 und Verwitwete. Daran änderte sich auch dann wenig, wenn man das Modell ausdrücklich bat, wie diese Gruppe zu antworten.
Für einen Umbau ist das heikel. Widerstand kommt selten vom Durchschnitt. Er kommt von der Teamleiterin kurz vor der Rente oder vom Kollegen, der als Einziger den alten Ablauf wirklich kennt. Genau diese Ränder glättet das Modell.
Grenze 3. Agenten passen sich in Gruppen an.
In einer synthetischen Organisation reden Agenten miteinander, etwa in einem simulierten Gremium. Was passiert dort?
Zhiyuan Weng, Guikun Chen und Wenguan Wang haben das 2025 auf der ICLR untersucht. Ein Modell beantwortete Denkaufgaben, nachdem 6 andere Agenten ihre Antwort genannt hatten. Gezählt wurde, wie oft es eine Aufgabe allein richtig löste und in der Gruppe falsch. Im Mittel von 5 Modellen geschah das je nach Anordnung in 23,5 % bis 47,2 % der Fälle. Die höchste Quote gab es, wenn die anderen Agenten erst danebenlagen und in der letzten Runde richtig. Beim offenen Modell Llama3-70B lag sie dort bei 69,9 %, also bei gut 2 von 3 Aufgaben. Ein gestärktes Rollenbild und eine Aufforderung zur Selbstprüfung senkten die Anpassung, bei einem Modell stieg sie aber sogar.
Was heißt das? Wenn ein simuliertes Gremium schnell einig ist, sagt das wenig über ein echtes Gremium. Die Einigkeit kann ein Effekt des Modells sein. Ob Agenten menschliches Gruppendenken vorhersagen, hat die Studie nicht geprüft.
Grenze 4. Mittelwerte stimmen und Zusammenhänge nicht.
Damit sind wir wieder bei der Szene vom Anfang. Bisbee und Kollegen zeigen, dass ein passender Durchschnitt nichts über die Zusammenhänge dahinter sagt.
Übertragen auf eine Organisation heißt das etwa so. Eine Simulation sagt, dass die neue Struktur im Mittel gut ankommt. Das kann stimmen. Wer sie ablehnt und warum, ist aber genau die Frage nach einem Zusammenhang. Und dort lag das Modell in der Studie oft daneben. Dazu kommt die zeitliche Unruhe. Wer eine Simulation in 3 Monaten wiederholt, bekommt womöglich ein anderes Ergebnis, ohne dass sich an der Organisation etwas geändert hat.
Grenze 5. Tacit Knowledge steht in keinem Prompt.
Der Philosoph Michael Polanyi hat 1966 einen Gedanken formuliert, der seither viel zitiert wird. Wir wissen mehr, als wir sagen können. Sein Beispiel ist ein Gesicht. Wir erkennen es unter Tausenden und können doch kaum beschreiben, woran. Im Deutschen heißt das implizites Wissen.
In Organisationen steckt dieses Wissen überall. Die Sachbearbeiterin weiß, welcher Antrag trotz vollständiger Unterlagen Ärger machen wird. Der Schichtleiter weiß, wen man nachts anrufen kann. In keiner Rollenbeschreibung steht das. Deshalb steht es auch in keiner Persona.
Dazu habe ich keine Studie gefunden, die das für Sprachmodelle in Organisationen misst. Das ist meine Deutung auf Grundlage von Polanyi. Ich halte sie für eine der wichtigsten Grenzen, gerade weil man sie im Ergebnis nicht sieht. Die Simulation läuft ja trotzdem glatt.
Grenze 6. Synthetische Daten sind nicht automatisch anonym.
Wer Personaldaten in eine Simulation steckt, greift gern zu künstlichen Daten. Die Hoffnung dahinter: Sie sehen aus wie echte Daten, gehören aber zu niemandem.
Theresa Stadler, Bristena Oprisanu und Carmela Troncoso haben das 2022 auf dem Sicherheitskongress USENIX Security geprüft. Sie testeten mehrere aktuelle Verfahren zur Erzeugung solcher Daten. Das Ergebnis war ernüchternd. Entweder ließen die synthetischen Daten weiterhin Rückschlüsse auf echte Personen zu. Oder sie verloren viel von ihrem Nutzen. Einen besseren Kompromiss als klassische Anonymisierung fanden sie nicht. Wie viel Schutz man bekommt, ließ sich außerdem schwer vorhersagen.
Ich bin kein Jurist und beurteile nicht, was daraus rechtlich folgt. Als Organisationsforscher würde ich synthetische Personaldaten so lange wie echte behandeln, bis jemand mit Fachwissen im Datenschutz das Gegenteil begründet hat.
Synthetic Data im Personalbereich →
Was folgt daraus für das Abgleichen?
Für die synthetische Organisation habe ich eine Prüfschleife mit 4 Schritten vorgeschlagen. Sie ist mein eigenes Modell und nicht in Studien getestet. Schritt 1 heißt Abbilden, Schritt 2 Besetzen, Schritt 3 Durchspielen. Schritt 4 heißt Abgleichen. Dort prüfen echte Menschen, was die Simulation nicht sieht.
Die Simulation zeigt, wo es haken könnte. Ob es dort wirklich hakt, wissen nur die Menschen, die die Arbeit tun.
Aus den 6 Grenzen leite ich Fragen für diesen Schritt ab. Das ist meine Ableitung, getestet ist sie nicht.
Erstens fragt man nach Abweichungen von der Vernunft. Wo würden Sie anders handeln, als die Rollenbeschreibung es verlangt? Damit hält man der zu rationalen Simulation den Alltag entgegen.
Zweitens fragt man nach der Streuung. Wer im Team sieht das ganz anders? Und man holt bewusst die Menschen dazu, die ein Modell schlecht abbildet, etwa die Älteren oder die Einzelnen mit seltenem Wissen.
Drittens misstraut man der schnellen Einigkeit. Hat ein simuliertes Gremium ohne Streit entschieden, legt man die Frage einem echten Gremium vor und schaut, wo es widerspricht.
Viertens nutzt man die Simulation für die Frage, wo etwas klemmt. Für die Frage, wer warum so reagiert, taugt sie nach der Studie von Bisbee wenig. Man wiederholt Läufe und notiert, mit welcher Modellversion sie liefen.
Fünftens fragt man die Menschen, die die Arbeit tun, ganz schlicht: Was fehlt in diesem Ablauf? Das ist die einzige Stelle, an der implizites Wissen überhaupt sichtbar werden kann.
Und sechstens klärt man vor dem ersten Lauf mit dem Datenschutz, welche Daten in die Simulation dürfen.
Was ich daraus mitnehme.
Die Grenzen sind kein Grund, auf Simulation zu verzichten. Sie sind ein Grund, ihr nicht das letzte Wort zu geben. Eine synthetische Organisation ist für mich ein Probelauf. Wie man den Probelauf für Freigaben konkret aufbauen kann, beschreibt der Beitrag Entscheidungsrechte: Wie man sie vor dem Umbau im Simulator testet.
Warum man einen Umbau erst simulieren sollte →Entscheidungsrechte im Simulator testen →
Vielleicht nehmen Sie 3 Fragen mit. Wer in Ihrer Organisation würde bei einem Umbau anders reagieren als der Durchschnitt? Würde ein Modell diese Person überhaupt sehen? Welches Wissen steckt in Ihren Abläufen, das nirgends aufgeschrieben ist? Und wer prüft bei Ihnen ein Simulationsergebnis, bevor jemand danach entscheidet?
Quellen
Aher, G., Arriaga, R. I., & Kalai, A. T. (2023): Using Large Language Models to Simulate Multiple Humans and Replicate Human Subject Studies. ICML 2023. https://arxiv.org/abs/2208.10264
Bisbee, J., Clinton, J. D., Dorff, C., Kenkel, B., & Larson, J. M. (2024): Synthetic Replacements for Human Survey Data? The Perils of Large Language Models. Political Analysis 32(4), 401–416. https://doi.org/10.1017/pan.2024.5
Liu, R., Geng, J., Peterson, J. C., Sucholutsky, I., & Griffiths, T. L. (2025): Large Language Models Assume People are More Rational than We Really are. ICLR 2025. https://arxiv.org/abs/2406.17055
Polanyi, M. (1966): The Tacit Dimension. Garden City, NY: Doubleday.
Santurkar, S., Durmus, E., Ladhak, F., Lee, C., Liang, P., & Hashimoto, T. (2023): Whose Opinions Do Language Models Reflect? ICML 2023, PMLR 202, 29971–30004. https://proceedings.mlr.press/v202/santurkar23a.html
Stadler, T., Oprisanu, B., & Troncoso, C. (2022): Synthetic Data – Anonymisation Groundhog Day. 31st USENIX Security Symposium, 1451–1468. https://www.usenix.org/conference/usenixsecurity22/presentation/stadler
Wang, A., Morgenstern, J., & Dickerson, J. P. (2025): Large language models that replace human participants can harmfully misportray and flatten identity groups. Nature Machine Intelligence 7 (3), 400–411. https://doi.org/10.1038/s42256-025-00986-z
Weng, Z., Chen, G., & Wang, W. (2025): Do as We Do, Not as You Think: the Conformity of Large Language Models. ICLR 2025. https://arxiv.org/abs/2501.13381
Was das für Ihre Organisation heißt. Im KI-Organisationslabor klären wir es gemeinsam am echten Fall.
Im KI-Organisationslabor bringen wir Agenten in den echten Betrieb und legen fest, wer welche Entscheidung trifft. Vorher rechnen wir Szenarien in Euro durch.
Jeden Monat eine Einordnung zu KI in Organisationen.
Einmal im Monat nehme ich mir ein Thema vor, das Organisationen gerade beschäftigt. Sie bekommen das Editorial und die neuen Analysen per Mail. Die erste Ausgabe per Mail kommt im Dezember.
Aktuell Ausgabe 1 · November 2026 · Wer wirklich im KI-Loop steht. Ausgabe lesen ›