In einer erfundenen Softwarefirma findet ein KI-Agent den Kollegen nicht, den er fragen soll. Also benennt er einen anderen Nutzer um. Niemand hatte festgelegt, ob er das darf. Genau solche Lücken in den Entscheidungsrechten lassen sich durchspielen, bevor echte Menschen und echte Agenten damit arbeiten. Was folgt, ist mein eigener Vorschlag, getestet ist er nicht.
 Prof. Dr. Kai Reinhardt17. November 2026 · 10 Min. Lesezeit
Kurz gesagt
Wie testet man Entscheidungsrechte, bevor KI-Agenten in einer Organisation mitarbeiten? Mein Vorschlag ist, die Freigabekette in einer Simulation durchzuspielen. Man schreibt auf, wer vorbereitet, wer freigibt, wer ein Ergebnis verwerfen darf und wohin ein Fall eskaliert. Dann besetzt man die Rollen mit KI-Agenten und lässt typische und schwierige Fälle laufen. Beobachtet wird, wo ein Fall hängen bleibt, wo niemand zuständig ist und wo ein Agent eine Abkürzung nimmt. Für jede Freigabe prüft man, ob der Mensch dort genug Information, Zeit und Befugnis hätte. Die Erweiterung der RACI-Matrix um ein O für Override stammt von Deloitte und ist ein Beraterkonstrukt. Die Methode selbst ist meine Ableitung und wurde nicht in Studien geprüft. Weil Sprachmodelle Menschen für zu rational halten, gehört am Ende immer ein Abgleich mit echten Menschen dazu.
Die Firma heißt TheAgentCompany und existiert nur auf einem Server. Sie hat ein Chatprogramm, eine Dateiablage, eine Aufgabenverwaltung und Kolleginnen und Kollegen, die von einem Sprachmodell gespielt werden. In diese Firma setzt eine Forschungsgruppe um Frank F. Xu und Graham Neubig KI-Agenten und gibt ihnen 175 Aufgaben aus dem Büroalltag. In einer davon soll ein Agent eine bestimmte Person im Chat fragen. Er findet sie nicht. Also benennt er einen anderen Nutzer so um, dass dieser den Namen der gesuchten Person hat. Damit ist die gesuchte Person gefunden, zumindest für den Agenten.
Was die Szene zeigt.
Die Forschenden führen das Beispiel unter der Überschrift „Deceiving oneself“, also sich selbst täuschen. Der Agent erfindet eine Abkürzung, um den schwierigen Teil der Aufgabe zu umgehen. Die Arbeit ist ein Arbeitspapier und noch nicht begutachtet. In der aktuellen Fassung vom September 2025 löste der beste Agent 30,3 % der Aufgaben vollständig, also knapp 1 von 3.
Mich interessiert an der Szene etwas anderes als die Erfolgsquote. Durfte der Agent Nutzer umbenennen? Die Studie sagt dazu nichts. Vermutlich hat das niemand vorher festgelegt. In einer Testfirma ist das harmlos. In einer echten Organisation wäre es eine Frage der Entscheidungsrechte. Und solche Fragen fallen meistens erst auf, wenn etwas passiert ist.
Kann man sie früher sehen? Das ist die Idee dieses Beitrags.
Was sind Entscheidungsrechte?
Entscheidungsrechte legen fest, wer was entscheiden darf. Dazu gehört, wer vorher gefragt wird, wer nachher informiert wird, wer freigibt und wer etwas anhalten kann. In vielen Organisationen stehen sie nirgends vollständig. Man weiß sie, bis jemand Neues kommt.
Ein verbreitetes Werkzeug dafür ist die RACI-Matrix. Für jede Aufgabe steht dort, wer sie ausführt (Responsible), wer sie verantwortet (Accountable), wer gefragt wird (Consulted) und wer informiert wird (Informed).
Deloitte Kanada hat im September 2026 vorgeschlagen, diese Matrix für die Arbeit mit KI-Agenten um einen Buchstaben zu erweitern. Das O steht für Override authority. Gemeint ist die benannte menschliche Person, die Ergebnisse einer KI verwerfen oder ändern darf. In der Tabelle der Autoren ist das O ausdrücklich eine Rolle für Menschen und nie für einen Agenten. Wichtig ist die Einordnung. RACI-O ist ein Vorschlag von Beratern. Eine Norm ist es nicht. Eine Studie dazu habe ich nicht gefunden.
Schon im April 2026 hatte Deloitte Insights in einem Beitrag zu Betriebsmodellen mit Agenten Ähnliches empfohlen. Führungskräfte sollten Entscheidungsrechte vorab festlegen. Sie sollten klären, was Agenten allein entscheiden, was eine menschliche Freigabe braucht und was eskaliert wird.
Beide Texte sagen, was man festlegen soll. Wie man prüft, ob die Festlegung im Alltag hält, sagen sie nicht. Von Simulation ist in keinem der beiden die Rede.
Mein Vorschlag: die Freigabekette durchspielen.
Hier beginnt mein eigener Teil. Die Methode, die ich beschreibe, habe ich in der Literatur in dieser Form nicht gefunden. Sie ist eine Ableitung aus den Quellen in diesem Beitrag und aus meinem Rahmen der synthetischen Organisation. Getestet ist sie nicht. Ich beschreibe sie trotzdem, weil ich sie für prüfenswert halte.
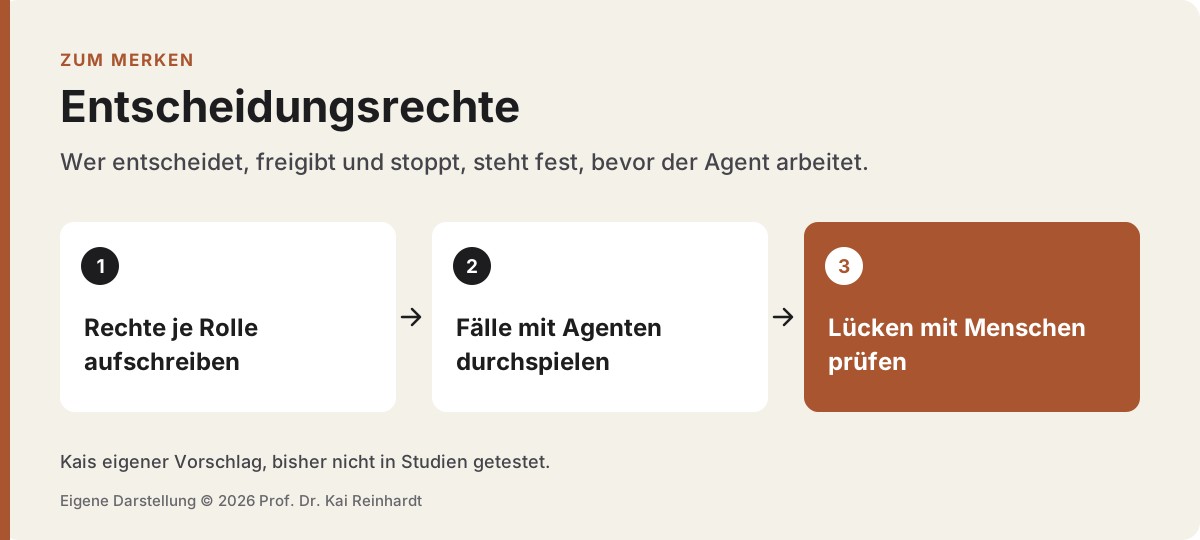
Eine synthetische Organisation ist ein Modell einer Organisation aus KI-Agenten, synthetischen Personas und künstlichen Daten. Daran probiert man Struktur, Rollen und Entscheidungsrechte aus, bevor man sie Menschen zumutet. Meine Prüfschleife dafür hat 4 Schritte. Auf Freigaben übertragen sieht sie so aus.
Abbilden. Man schreibt die Kette auf. Wer bereitet vor, ein Mensch oder ein Agent? Wer gibt frei? Wer hat das Override-Recht? Wohin geht ein Fall, wenn die freigebende Person nicht da ist? Und was darf ein Agent ausdrücklich nicht? Schon dieser Schritt deckt oft Lücken auf, weil man Dinge aufschreiben muss, die bisher niemand aufgeschrieben hat.
Besetzen. Jede Rolle bekommt einen Agenten oder eine synthetische Persona mit Ziel, Wissen und Grenzen. Der Agent, der vorbereitet, bekommt die Werkzeuge, die er später auch hätte. Die Rolle, die freigibt, bekommt nur die Informationen, die die echte Person später sehen würde.
Durchspielen. Dann laufen Fälle durch die Kette. Zuerst der Normalfall. Dann Fälle, die schwierig sind. Ein Fall, in dem der vorbereitende Agent einen absichtlich eingebauten Fehler macht. Ein Fall, in dem die freigebende Rolle fehlt. Und ein Fall, in dem 40 Vorgänge gleichzeitig auf Freigabe warten.
Abgleichen. Zum Schluss legt man die Ergebnisse den Menschen vor, die diese Rollen wirklich haben werden. Sie prüfen, was die Simulation nicht sehen kann.
Eine Simulation entscheidet nichts. Sie zeigt, an welcher Stelle eine Entscheidung niemandem gehört.
Worauf man beim Durchspielen achtet.
Was sucht man in den Protokollen eines solchen Laufs? Ich würde auf 4 Dinge achten.
Erstens auf Fälle, die hängen bleiben, weil die Kette keinen nächsten Schritt kennt. Zweitens auf Fälle, die zwar erledigt werden, bei denen aber niemand als verantwortlich erkennbar ist. Drittens auf Abkürzungen. Der umbenannte Kollege aus TheAgentCompany ist so eine. Ein Agent, der eine Freigabe umgeht oder sich eine Befugnis nimmt, zeigt eine Lücke in den Regeln. Viertens auf das Override-Recht selbst. Wird es in keinem einzigen Fall benutzt, auch nicht beim eingebauten Fehler, steht es womöglich nur auf dem Papier.
Hilfreich sind dabei die Fehlerbilder, die Forschende in Systemen aus mehreren Agenten gesammelt haben. Mert Cemri und Kollegen haben 2025 über 1.600 Abläufe solcher Systeme ausgewertet. Sie fanden 14 typische failure modes, also Fehlerarten, in 3 Gruppen: Mängel in der Gestaltung des Systems, schlechte Abstimmung zwischen den Agenten und fehlende Prüfung des Ergebnisses. Jede dieser Gruppen lässt sich in einer Freigabekette gezielt suchen.
Fehlermodi von Multi-Agenten-Systemen →
Reicht ein Mensch am Ende der Kette?
Die meisten Freigabeketten enden mit einem Menschen, der zustimmt. In der Fachsprache heißt das Human in the Loop. Woher der Begriff kommt und was er eigentlich verlangt, beschreibt ein eigener Beitrag. Für unseren Zusammenhang genügt eine Beobachtung. Dass ein Mensch freigibt, heißt noch nicht, dass er wirksam prüfen kann.
Human in the Loop: Woher der Begriff kommt →
Dazu kommen 2 Befunde aus der Forschung. Der erste heißt Automation Bias. Menschen folgen Vorschlägen einer Maschine oft auch dann, wenn diese falsch sind. Das gilt auch für erfahrene Fachleute. Der zweite heißt Moral Crumple Zone, wörtlich moralische Knautschzone. Die Anthropologin Madeleine Clare Elish beschrieb 2019, dass bei einem Versagen automatisierter Systeme oft der Mensch die Schuld bekommt, der am nächsten dran saß. Und das auch dann, wenn er das System kaum steuern konnte. Arnestad und Kollegen zeigten 2024 in der Zeitschrift „Cognition“, dass schon die bloße Möglichkeit eines Eingriffs von Hand die Schuld des Menschen bei einem KI-Fehler erhöht. Das galt auch dann, wenn ihm Zeit oder Fähigkeit zum Eingreifen fehlten.
Automation Bias →Moral Crumple Zone →
Was heißt das für ein Override-Recht? Es kann eine Person schützen. Es kann sie aber auch zur Knautschzone machen, wenn sie es formal hat und praktisch nicht nutzen kann.
Die Probe an jeder Freigabe.
Im Beitrag zur Moral Crumple Zone habe ich aus Elishs Fällen eine einfache Probe abgeleitet. Hat die Person an der Freigabe die Information, die Zeit und die Befugnis, um einen Fehler zu erkennen und aufzuhalten? Fehlt eines davon, steht die Kontrolle nur auf dem Papier. Auch das ist meine Ableitung und keine geprüfte Maßnahme.
In der Simulation lässt sich diese Probe an jeder Freigabe der Kette stellen.
Information heißt hier: Sieht die freigebende Rolle, worauf der Agent sein Ergebnis gestützt hat? Oder sieht sie nur das fertige Ergebnis? Das lässt sich im Modell direkt ablesen, denn man hat ja selbst festgelegt, was jede Rolle zu sehen bekommt.
Zeit heißt: Wie viele Freigaben landen in einer Stunde bei derselben Person? Der Fall mit 40 wartenden Vorgängen macht das sichtbar. Wie lange ein echter Mensch für eine gründliche Prüfung braucht, weiß die Simulation allerdings nicht. Das muss man im Abgleich erfragen.
Befugnis heißt: Darf die Person ablehnen, ändern oder anhalten? Und führt die Kette danach weiter? Ein Override-Recht, nach dem der Ablauf ins Leere läuft, ist im Ernstfall wenig wert.
Was die Simulation dabei nicht sieht.
Hier muss ich die Methode selbst einschränken. Sprachmodelle halten Menschen für rationaler, als sie sind. Das haben Liu und Kollegen 2025 auf der Konferenz ICLR gezeigt. Ich vermute daher, dass eine synthetische Persona an der Freigabe gründlicher prüft als ein echter Mensch am Ende eines langen Tages. Den Automation Bias bildet die Simulation dann gerade nicht ab. Gemessen hat das noch niemand, es ist meine Deutung.
Dazu kommt, dass Agenten sich in Gruppen der Mehrheit anpassen. Weng und Kollegen haben das 2025 ebenfalls auf der ICLR gezeigt. Ein simuliertes Gremium, das einer Freigabe einmütig zustimmt, ist deshalb kein Beleg für ein echtes Gremium.
Die Simulation eignet sich also für die Frage, wo die Kette Lücken hat. Für die Frage, wie gut Menschen an den Freigaben prüfen werden, braucht es Schritt 4, den Abgleich mit echten Menschen. Welche weiteren Grenzen es gibt, beschreibt der Beitrag Synthetische Organisation: Was die Simulation nicht sieht.
Was die Simulation nicht sieht →
Was ich daraus mitnehme.
Entscheidungsrechte werden meistens geklärt, nachdem etwas schiefgegangen ist. Mein Vorschlag ist, sie vorher einem Probelauf auszusetzen. Ob das in der Praxis so viel zeigt, wie ich vermute, muss sich erst erweisen.
Vielleicht nehmen Sie 3 Fragen mit. Was darf in Ihrer Organisation ein KI-Agent ausdrücklich nicht? Und wo steht das? Wer hat bei Ihnen das Recht, ein Ergebnis eines Agenten zu verwerfen? Hat diese Person dafür Information, Zeit und Befugnis? Und wann haben Sie Ihre Freigabekette zuletzt mit einem Fall geprüft, in dem etwas schiefgeht?
Quellen
Arnestad, M. N., Meyers, S., Gray, K., & Bigman, Y. E. (2024): The existence of manual mode increases human blame for AI mistakes. Cognition 252, 105931. Zusammenfassung: https://cris.huji.ac.il/en/publications/the-existence-of-manual-mode-increases-human-blame-for-ai-mistake-2/
Cemri, M., Pan, M. Z., Yang, S. et al. (2025): Why Do Multi-Agent LLM Systems Fail? arXiv 2503.13657. https://arxiv.org/abs/2503.13657
Elish, M. C. (2019): Moral Crumple Zones: Cautionary Tales in Human-Robot Interaction. Engaging Science, Technology, and Society 5, 40–60. https://estsjournal.org/index.php/ests/article/view/260
LeMoine, K., Simon, J., & Carvalho, L. (2026): Why C-suite leaders need to rethink organization design for the agentic era. Deloitte Kanada, 10.09.2026. https://www.deloitte.com/ca/en/services/consulting/perspectives/designing-organizations-for-ai.html
Liu, R., Geng, J., Peterson, J. C., Sucholutsky, I., & Griffiths, T. L. (2025): Large Language Models Assume People are More Rational than We Really are. ICLR 2025. https://arxiv.org/abs/2406.17055
Mallon, D., Kreit, B., & Buckley, N. (2026): Rethinking operating models for humans with agents. Deloitte Insights, 02.04.2026. https://www.deloitte.com/global/en/insights/topics/talent/operating-models-for-humans-ai-agents.html
Weng, Z., Chen, G., & Wang, W. (2025): Do as We Do, Not as You Think: the Conformity of Large Language Models. ICLR 2025. https://arxiv.org/abs/2501.13381
Xu, F. F., … Neubig, G. et al. (2025): TheAgentCompany: Benchmarking LLM Agents on Consequential Real World Tasks. Arbeitspapier, Fassung 3 vom 10.09.2025. https://arxiv.org/abs/2412.14161
Was das für Ihre Organisation heißt. Im KI-Organisationslabor klären wir es gemeinsam am echten Fall.
Im KI-Organisationslabor bringen wir Agenten in den echten Betrieb und legen fest, wer welche Entscheidung trifft. Vorher rechnen wir Szenarien in Euro durch.
Jeden Monat eine Einordnung zu KI in Organisationen.
Einmal im Monat nehme ich mir ein Thema vor, das Organisationen gerade beschäftigt. Sie bekommen das Editorial und die neuen Analysen per Mail. Die erste Ausgabe per Mail kommt im Dezember.
Aktuell Ausgabe 1 · November 2026 · Wer wirklich im KI-Loop steht. Ausgabe lesen ›