Ein Agent kennt das richtige Format für einen Benutzernamen und sagt es nicht weiter. Ein anderer fragt nicht nach. Der Auftrag scheitert. Eine Forschungsgruppe aus Berkeley hat über 1.600 solcher Läufe ausgewertet und 14 Fehlermodi gefunden.
 Prof. Dr. Kai Reinhardt17. November 2026 · 5 Min. Lesezeit
Kurz gesagt
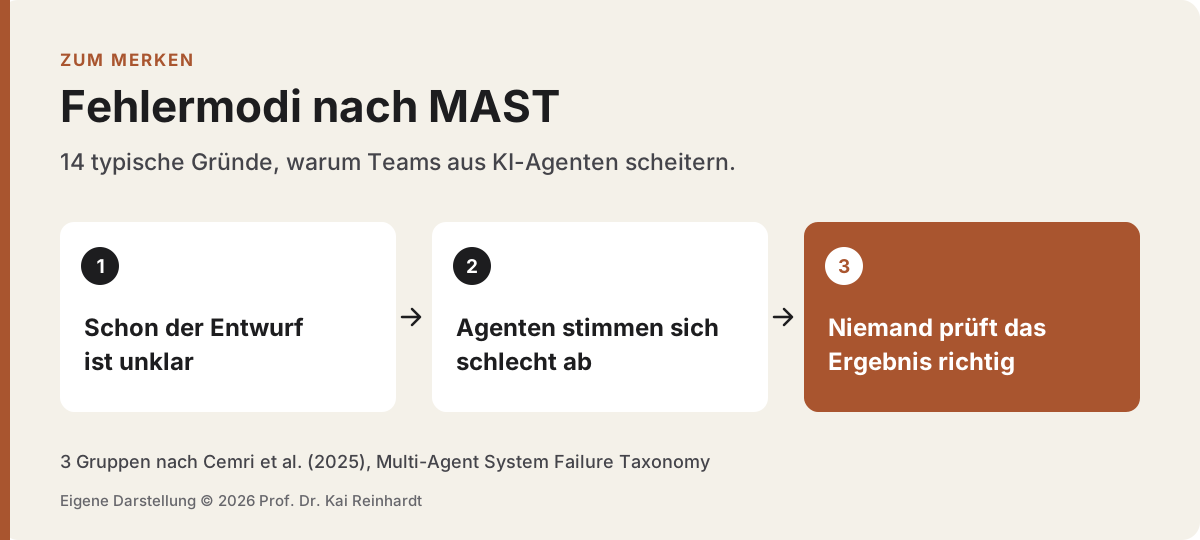
Was sind die Fehlermodi von Multi-Agenten-Systemen? Gemeint sind die typischen Arten, auf die Teams aus mehreren KI-Agenten an einer Aufgabe scheitern. Mert Cemri und Kollegen haben dafür 2025 die Multi-Agent System Failure Taxonomy (MAST) vorgelegt, vorgestellt auf der Konferenz NeurIPS. Sie beruht auf 1.642 ausgewerteten Läufen aus 7 Agentensystemen. Die 14 Fehlermodi fallen in 3 Gruppen. Die erste betrifft den Entwurf des Systems, etwa missachtete Aufgaben oder Rollen. Die zweite betrifft die Abstimmung zwischen den Agenten, etwa zurückgehaltene Information. Die dritte betrifft die Prüfung des Ergebnisses. Viele Fehler entstehen nach den Autoren aus der Gestaltung des Systems. Schwächen des Sprachmodells erklären nur einen Teil. Bessere Rollenbeschreibungen und eine zusätzliche Prüfung verbesserten die Ergebnisse, lösten das Problem aber nicht.
Mehrere KI-Agenten sollen gemeinsam einen Auftrag erledigen, für den sie sich bei einem Dienst anmelden müssen. Ein Agent ist für die Telefonfunktionen zuständig. Er kennt die Vorgaben der Schnittstelle, auch das Format, in dem der Benutzername stehen muss. Er gibt dieses Wissen nicht an den Agenten weiter, der die Arbeit steuert. Der steuernde Agent fragt auch nicht nach. Die Anmeldung schlägt fehl, wieder und wieder. Am Ende scheitert der ganze Auftrag.
Diesen Lauf zeigen Mert Cemri und Kollegen in ihrer Arbeit „Why Do Multi-Agent LLM Systems Fail?“ als Beispiel. Er ist einer von 1.642, die sie ausgewertet haben.
Was ist ein Multi-Agenten-System?
Ein KI-Agent ist ein Programm auf Basis eines Sprachmodells, das eine Aufgabe in mehreren Schritten selbst erledigt. In einem Multi-Agenten-System arbeiten mehrere solcher Agenten zusammen. Jeder hat eine Rolle, etwa Planer, Programmierer oder Prüfer. Die Idee klingt vertraut. Man teilt Arbeit auf, damit jeder sich auf seinen Teil konzentrieren kann.
Die Autoren beginnen mit einer ernüchternden Beobachtung. Auf gängigen Testaufgaben bringen solche Systeme oft nur geringe Leistungsgewinne. Je nach System scheiterten in ihrer Auswertung zwischen 41 und 86,7 Prozent der Aufgaben. Die Werte stammen allerdings aus unterschiedlichen Aufgaben und sind nicht direkt vergleichbar.
Was sind Fehlermodi nach MAST?
Ein Fehlermodus ist eine typische Art zu scheitern. Cemri und Kollegen haben die Fehlermodi von Agententeams in einer Liste geordnet und ihr einen Namen gegeben: Multi-Agent System Failure Taxonomy, kurz MAST.
Wie kamen sie darauf? Zuerst lasen 6 Fachleute 150 Läufe von Hand und notierten, was schiefging. Daraus entstand die Liste. Mehrere Prüfer ordneten danach dieselben Läufe unabhängig voneinander zu und kamen zu fast denselben Ergebnissen. Für die übrigen Läufe setzten die Autoren ein Sprachmodell als Gutachter ein, dessen Urteile gut mit denen der Fachleute übereinstimmten. Die Arbeit wurde 2025 auf der Konferenz NeurIPS vorgestellt.
Welche Fehler kommen am häufigsten vor?
Die erste Gruppe betrifft den Entwurf des Systems, im Original system design issues. Hier liegen die meisten Fehler. Am häufigsten wiederholen Agenten Arbeitsschritte, die schon erledigt sind. Das betrifft 15,7 Prozent der Fehler, also etwa jeden 6. Oft weiß auch kein Agent, wann die Arbeit fertig ist (12,4 Prozent). Oder ein Agent hält sich nicht an die Aufgabe (11,8 Prozent).
Die zweite Gruppe betrifft die Abstimmung zwischen den Agenten, im Original inter-agent misalignment. Ein Agent behält Wissen für sich, fragt nicht nach oder übergeht, was ein anderer gesagt hat. Häufig ist hier auch ein Bruch zwischen Denken und Handeln. Der Agent begründet richtig, was zu tun wäre, und tut dann etwas anderes (13,2 Prozent).
Die dritte Gruppe betrifft die Prüfung, im Original task verification. Das bekannteste Beispiel stammt aus dem System ChatDev. Es sollte ein Schachprogramm schreiben. Der prüfende Agent kontrollierte vor allem, ob sich der Code übersetzen ließ. Ob die Schachregeln stimmten, prüfte er nicht. Das Programm bestand die Prüfung und war trotzdem nicht benutzbar.
Das Schachprogramm hat jede Prüfung bestanden. Spielen konnte man damit nicht.
Liegt das am Sprachmodell?
Nur zum Teil. Die Autoren sehen viele Fehler in der Gestaltung des Systems und erwarten, dass bessere Modelle allein nicht genügen. Sie berufen sich dabei auf die Forschung zu Organisationen mit hoher Zuverlässigkeit (im Original High-Reliability Organizations) und auf Charles Perrow. Danach können Organisationen aus fähigen Mitgliedern schwer scheitern, wenn ihre Struktur fehlerhaft ist. Ihre eigenen Versuche passen dazu. Genauere Rollenbeschreibungen und ein zusätzlicher Prüfschritt verbesserten die Ergebnisse von ChatDev. Gelöst war das Problem damit nicht.
Ein Team um Phanish Puranam von INSEAD hat die Liste 2026 neu sortiert. MAST ordnet Fehler danach, wann sie auftreten. Puranam und Kollegen ordnen sie nach der Ursache im Entwurf. Das beschreibt der Beitrag Artificial Organization.
Was bedeutet das für eine synthetische Organisation?
Synthetische Organisation nenne ich ein Modell einer Organisation aus KI-Agenten, synthetischen Personas und künstlichen Daten. An diesem Modell probiert man Struktur, Rollen und Entscheidungsrechte aus, bevor man sie Menschen zumutet. Das Dossier Synthetische Organisation beschreibt den Rahmen.
Meine Prüfschleife dafür ist ein eigenes Modell mit 4 Schritten: Abbilden, Besetzen, Durchspielen, Abgleichen. MAST greift vor allem im dritten Schritt. Beim Durchspielen lässt man Fälle laufen und markiert Engpässe und Lücken. Die 14 Fehlermodi sind dafür eine fertige Liste von Stellen, an denen man hinschauen sollte. Wird Wissen zurückgehalten? Weiß jemand, wann die Arbeit fertig ist? Prüft der Prüfer das Richtige?
Ich vermute außerdem, dass die Liste schon beim Abbilden nützt. Wer Übergaben beschreibt, kann für jede Übergabe fragen, wer welches Wissen weitergeben muss. Das ist meine Übertragung. Ob die Fehlermodi auch Übergaben zwischen Menschen beschreiben, hat die Studie nicht gemessen.
Artificial Organization → Entscheidungsrechte testen →
Was ich daraus mitnehme.
Vielleicht nehmen Sie 3 Fragen mit. Wenn in Ihrer Organisation KI-Agenten Arbeit untereinander übergeben, wer hat festgelegt, welches Wissen bei jeder Übergabe mitgehen muss? Ist für jeden Ablauf klar, wann er beendet ist? Und prüft die letzte Kontrolle, ob das Ergebnis seinen Zweck erfüllt, oder nur, ob es formal vollständig ist?
Quellen
Arrieta, J., He, V. F., Puranam, P., & Shrestha, Y. R. (2026): Multi-Agent AI Systems Are Organizations. INSEAD Working Paper 2026/49/STR. https://www.insead.edu/faculty-research/publications/working-papers/multi-agent-ai-systems-are-organizations
Cemri, M., Pan, M. Z., Yang, S., Agrawal, L. A., Chopra, B., Tiwari, R., Keutzer, K., Parameswaran, A., Klein, D., Ramchandran, K., Zaharia, M., Gonzalez, J. E., & Stoica, I. (2025): Why Do Multi-Agent LLM Systems Fail? NeurIPS 2025. https://arxiv.org/abs/2503.13657 · Konferenzseite: https://neurips.cc/virtual/2025/poster/121528
Was das für Ihre Organisation heißt. Im KI-Organisationslabor klären wir es gemeinsam am echten Fall.
Im KI-Organisationslabor bringen wir Agenten in den echten Betrieb und legen fest, wer welche Entscheidung trifft. Vorher rechnen wir Szenarien in Euro durch.
Jeden Monat eine Einordnung zu KI in Organisationen.
Einmal im Monat nehme ich mir ein Thema vor, das Organisationen gerade beschäftigt. Sie bekommen das Editorial und die neuen Analysen per Mail. Die erste Ausgabe per Mail kommt im Dezember.
Aktuell Ausgabe 1 · November 2026 · Wer wirklich im KI-Loop steht. Ausgabe lesen ›